# Forward Pass und Loss: Wie das Modell seinen eigenen Fehler misst
Wie aus den Prozenten eines Sprachmodells für das tatsächlich folgende Token Strafpunkte werden, wie daraus eine einzige Zahl für einen ganzen Stapel Text entsteht und was diese Zahl nicht misst.
Im vorigen Baustein lag eine Abdeckkarte auf dem Text. Das Modell rät das nächste Stück, und unter der Karte liegt die Lösung. Von sich aus gibt ein Sprachmodell aber keine einzelne Antwort ab. Es verteilt Prozente auf alle [Tokens](https://ki-einfach-verstehen.de/de/glossar/token/), die es kennt. Bei einem Test gibt es Punkte für richtig und keine für falsch. Wie bewertest du eine Vorhersage, die 72 Prozent auf das richtige Wort setzt und den Rest auf andere?
Die Antwort steckt in der Trainingsschleife aus dem Baustein über [Parameter, Training und Benutzen](https://ki-einfach-verstehen.de/de/bausteine/parameter-training-inferenz-hardware/): Rechnen, Vergleichen, Nachstellen. Beim Vergleichen entsteht eine Fehlerzahl, und sie hieß dort **[Loss](https://ki-einfach-verstehen.de/de/glossar/loss/)**, englisch für Verlust. Er ist umso größer, je weniger Prozent das Modell dem Textstück gab, das im Trainingstext tatsächlich folgt. Erinnerst du dich an das Apfel-Modell? Dort wurde jede Abweichung zwischen Vorhersage und Preis mit sich selbst multipliziert. Für Prozente braucht es eine andere Regel. Die Fehlerzahl einer einzelnen Vorhersage heißt in diesem Baustein Strafpunkte; gemittelt über alle Vorhersagen ergeben sie den Loss. Bevor du weiterliest, schätz selbst, wer mehr Strafpunkte bekommen sollte: ein Modell mit 1 Prozent auf dem richtigen Token oder eines mit 27 Prozent, und wie viel mehr.
## Strafpunkte für eine Vorhersage
Erinnerst du dich an das Glücksrad aus dem Baustein über [Wahrscheinlichkeit und Softmax](https://ki-einfach-verstehen.de/de/bausteine/wahrscheinlichkeit-und-softmax/)? Nach „Die Katze“ machte [Softmax](https://ki-einfach-verstehen.de/de/glossar/softmax/) aus drei ausgedachten Scores ein Rad: „sitzt“ bekam ein Feld von rund 72 Prozent, „schläft“ rund 27, „fliegt“ rund 1 Prozent. Jedes Feld ist so groß wie seine [Wahrscheinlichkeit](https://ki-einfach-verstehen.de/de/glossar/wahrscheinlichkeit/). Im Trainingstext folgt „sitzt“. Dieses Token ist das [Label](https://ki-einfach-verstehen.de/de/glossar/label/), die Lösung unter der Karte.
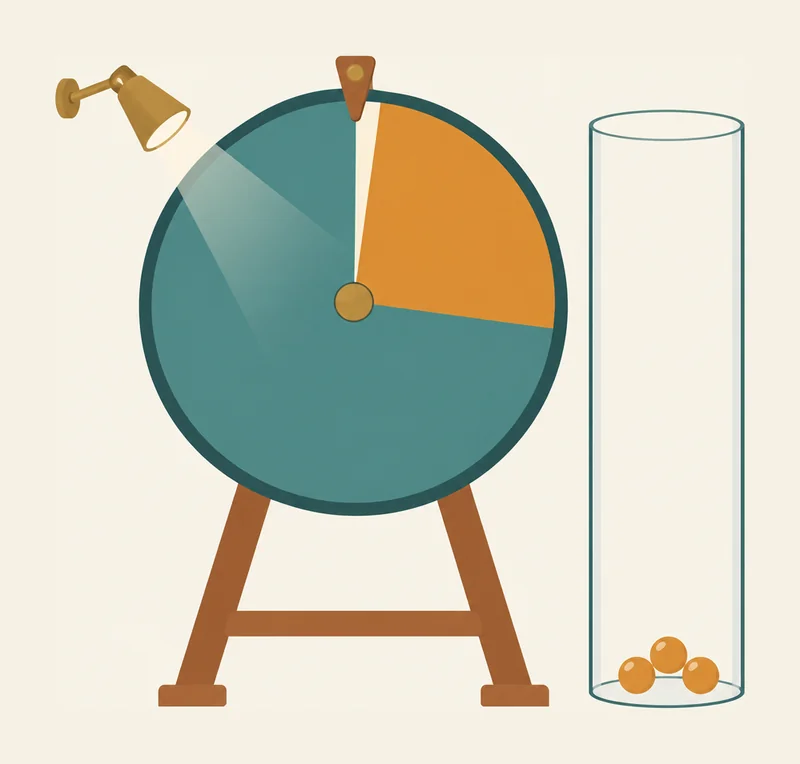
*Das Rad nach „Die Katze“: Die Lampe markiert das Feld des Tokens, das im Text tatsächlich folgt; nur dieses Feld zählt. Großes Feld, wenige Strafpunkte im Glas (schematisch).*
Die Regel schaut nur auf sein Feld: Ist es groß, gibt es wenig Strafpunkte, ist es klein, viele. Wie die anderen Felder verteilt sind, zählt nicht. Zwei Dinge passen an diesem Bild nicht. Erstens wird im Training nicht gedreht, das nächste Token steht schon im Text. Zweitens straft niemand. Das Modell spürt nichts. Die Strafpunkte, im Bild die Kugeln im Glas, sind eine Zahl, die der [Trainingsalgorithmus](https://ki-einfach-verstehen.de/de/glossar/trainingsalgorithmus/) später kleiner machen soll, indem er die [Parameter](https://ki-einfach-verstehen.de/de/glossar/parameter/) verstellt. Und anders als ein Glas, das irgendwann voll ist, haben die Strafpunkte keine Obergrenze.
Strafpunkte sind kein Prozentwert, und sie zählen auch nicht die Prozentpunkte. Ein Zuwachs von ein paar Prozentpunkten macht bei einem kleinen Feld viel aus, bei einem großen fast nichts.
Gezählt wird deshalb, wie oft man das Feld halbieren müsste, um von der ganzen Scheibe auf seine Größe zu kommen. **Jedes Halbieren des Felds kostet rund 0,7 Strafpunkte mehr**, ganz gleich, wie groß das Feld vorher war. Je kleiner das Feld, desto teurer. Die Reihe zeigt es in der Grafik.
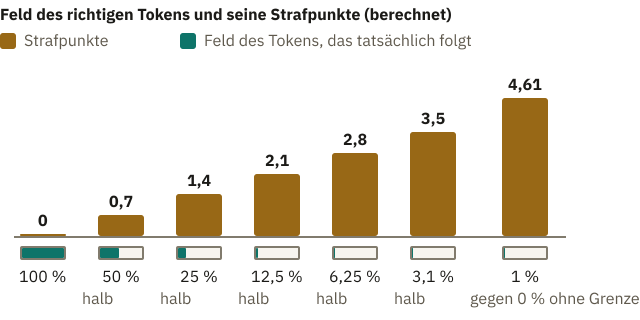
*Jedes Halbieren des Felds kostet rund 0,7 Strafpunkte mehr. Gegen null wachsen die Strafpunkte ohne Grenze (berechnet).*
Bei „sitzt“ mit 72 Prozent ist das knapp eine halbe Halbierung, also 0,33 Strafpunkte.
„Schläft“ mit 27 Prozent kostet rund 1,3. „Fliegt“ mit 1 Prozent kostet mehr als dreimal so viel.
Was kostet ein halb so großes Feld, 36 Prozent?
> **Interaktive Demo:** [auf der Website ausprobieren](https://ki-einfach-verstehen.de/de/bausteine/forward-pass-und-loss/)
Bei 36 Prozent sind es 1,02, also ein Halbieren mehr als bei 72 Prozent. Woher diese Zahl kommt, zeigt die Box am Ende dieses Abschnitts.
Setzt das Modell 98 Prozent auf „fliegt“, bleibt für „sitzt“ nur ein schmaler, teurer Streifen. Das ist die selbstsicher falsche Vorhersage, und sie kostet am meisten.
Knapp daneben ist billig: Gibt das Modell „schläft“ 60 Prozent und „sitzt“ 40, zahlt es nur rund 0,9. Fachleute nennen diese Regel **Cross-Entropy** (Kreuzentropie); sie liefert die Strafpunkte einer Position.
Auch wer vorn liegt, zahlt. Das kleine, frei verfügbare Modell Qwen3-0.6B gab im Baustein über den [Output Head](https://ki-einfach-verstehen.de/de/bausteine/output-head/) nach „Die Hauptstadt von Frankreich ist“ dem Token „Paris“ knapp die Hälfte aller Prozente, mehr als jedem anderen. Folgt im Trainingstext „Paris“, zahlt es trotzdem. Zuerst zählt für jede Position allein das eine Feld, das im Text folgt; erst danach wird gemittelt. Das gilt gleich, ob das Modell sicher oder unsicher ist, und ob das Wort ein häufiges oder ein seltenes ist. **Jede Vorhersage unter 100 Prozent kostet etwas.** Genauso rechnet das Grundtraining der Sprachmodelle hinter den Chatbots, die du benutzt; das Nachtraining auf Gespräche folgt danach.
Eine Ebene tiefer: Die Formel hinter den Strafpunkten
Die Strafpunkte einer Position sind
`Strafpunkte = −ln p`
Dabei ist p die Wahrscheinlichkeit des Tokens, das tatsächlich folgt, als Zahl zwischen 0 und 1, also 0,72 statt 72 Prozent. ln ist der natürliche Logarithmus. Für Zahlen unter 1 ist er negativ, das Minus macht die Strafpunkte positiv: −ln 0,5 ist 0,693.
Der Logarithmus verwandelt Malnehmen in Zusammenzählen. Halbieren heißt mal ½ nehmen, und das wird zu „plus 0,693“, unabhängig von der Größe des Felds. Daher kommt die Reihe mit den 0,7 Schritten.
Die verbreitete Trainingsbibliothek PyTorch bekommt dafür die Scores vor Softmax, die Logits, und das Label, rechnet Softmax und Logarithmus in einem Zug und mittelt über alle Positionen.
Ein Satz hat aber nicht nur eine Position.
## Vorwärts durch das Modell, eine Zahl für den Batch
Im Baustein über den Output Head lief „Der Hund jagt die Katze“ durch das Modell, jedes Wort vereinfacht als ein [Token](https://ki-einfach-verstehen.de/de/glossar/token/). Im Training liefert jede Position ihre Tafel, eine Liste mit einem Score für jedes Token im Vokabular. Vier davon lassen sich prüfen: „Der“ soll „Hund“ vorhersagen, „Hund“ das Wort „jagt“, „jagt“ das Wort „die“ und „die“ das Wort „Katze“. Für „Katze“ steht das nächste Token nicht mehr im Text.
Dafür läuft das Modell den bekannten Weg: Jedes Token holt sich seinen Steckbrief, das Embedding. Die Blöcke mischen Schicht für Schicht den Kontext ein. Der Output Head macht daraus für jede Position eine Liste mit einem Wert pro Token, Softmax ein Rad. Fachleute nennen diesen Weg **[Forward Pass](https://ki-einfach-verstehen.de/de/glossar/forward-pass/)**, auf Deutsch Vorwärtsdurchlauf.
Beim Antworten läuft derselbe Weg. So misst das Training genau das, was das Modell später ausgibt. Im Training bekommt jede Position aber den echten bisherigen Text, beim Antworten dagegen das, was das Modell selbst schon geschrieben hat.
Jedes der vier Wörter kostet Strafpunkte nach dem Feld, das ihm die Position davor gab.
Die Felder sind ausgedacht: Für „Hund“ bekäme das richtige Wort nur 1 Prozent, für „Katze“ 12,5 Prozent. Die übrigen zeigt die Grafik.
Am teuersten ist deshalb „Hund“: Nach „Der“ kommen viele Wörter in Frage, also bekommt das richtige nur ein kleines Feld. Nach „jagt“ ist „die“ dagegen naheliegend und billig.
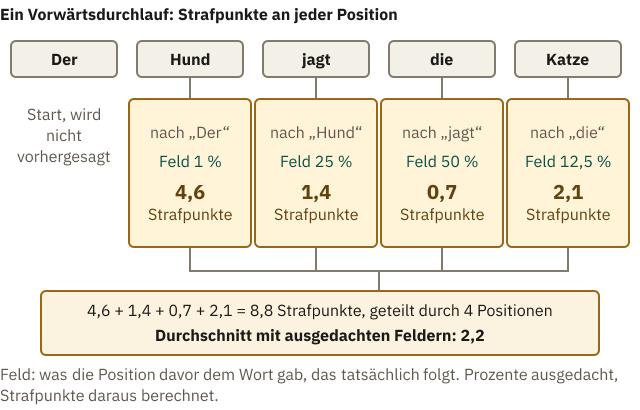
*Ein Vorwärtsdurchlauf, vier Vorhersagen: Unter jedem vorhergesagten Wort steht, wie groß sein Feld nach dem Wort davor war und was das kostet. Der Satz bekommt den Durchschnitt (ausgedachte Prozente).*
Aus den vier Werten wird eine Zahl, der Durchschnitt: 8,8 Strafpunkte geteilt durch vier Positionen ergibt 2,2, den Loss dieses Satzes. Warum nicht die Summe? Ein langer Text hätte dann allein wegen seiner Länge den größeren Loss, selbst bei gleich guten Vorhersagen. Der Durchschnitt macht Texte verschiedener Länge vergleichbar. Ob ein Satz als Ganzes stimmt, sagt der Loss nicht: Er misst jede einzelne Vorhersage und mittelt erst am Ende.
Jetzt mit echten Zahlen: Qwen3-0.6B, die frei verfügbare Grundfassung ohne Chat-Training, hat genau diesen Satz durchgerechnet.
Der [Tokenizer](https://ki-einfach-verstehen.de/de/glossar/tokenizer/), das Programm, das Text in Tokens zerlegt, macht daraus sieben Tokens: „Der“, „Hund“, „jag“, „t“, „die“, „Kat“ und „ze“. „Der“ wird nicht vorhergesagt, weil nichts davor steht; so ergeben sieben Tokens sechs Strafpunkt-Werte. Ihr Durchschnitt ist 4,8. Welches Token kostet wohl am meisten?
> **Interaktive Demo:** [auf der Website ausprobieren](https://ki-einfach-verstehen.de/de/bausteine/forward-pass-und-loss/)
Am teuersten sind „Hund“ und „jag“ mit je rund 11 Strafpunkten. Für „Hund“ blieb ein winziges Feld. Nach „Der Hund“ hätte das Modell eher das Stück „ert“ erwartet, wie in „Hundert“. Alle Felder ergeben zusammen 100 Prozent: Was auf „ert“ entfiel, fehlte für „jag“.
Am billigsten ist „ze“ nach „Kat“ mit 0,16, denn welches Stück sonst sollte folgen?
Das Training rechnet nicht mit einem einzelnen Satz. Im Baustein über Training stellte der Algorithmus die Parameter nach, sobald die Steigungen aus einem großen Stapel gesammelt waren. Diesen Stapel nennen Fachleute **[Batch](https://ki-einfach-verstehen.de/de/glossar/batch/)**. Im Baustein über Input und Output hieß Batch viele Anfragen auf einmal; hier ist es der Stapel, aus dem eine Fehlerzahl wird. Alle Folgen des Batches laufen vorwärts, jede Position bekommt ihre Strafpunkte, und der Durchschnitt über alle Positionen ist der Loss des Batches.
Wie groß so ein Stapel ist, zeigt GPT-3 von OpenAI aus dem Jahr 2020. Laut Forschungspapier lag sie bei der größten Fassung bei rund 3,2 Millionen Tokens. Aus Millionen Strafpunkten wird also eine einzige Zahl.
Beim Antworten braucht jedes neue Token einen Vorwärtsdurchlauf, denn das Modell schreibt Token für Token. Im Training läuft ein vorliegendes Textstück einmal vorwärts, alle Positionen zugleich. Dazu kommt der Rückweg, auf dem der Fehler zurückläuft; er braucht etwa doppelt so viel Rechenarbeit wie der Vorwärtsdurchlauf. Im Training kostet ein Textstück also rund das Dreifache eines Vorwärtsdurchlaufs.
Was sagt diese eine Zahl, und was sagt sie nicht?
## Was der Loss sagt und was nicht
Eine gute Vergleichsmarke ist ein Modell ohne Training. Seine Parameter starten mit Zufallswerten, sodass alle Scores nah beieinanderliegen. Dann verteilt Softmax das Rad fast gleichmäßig. Bei den 151.936 Tokens von Qwen3-0.6B bekäme jedes ein gleich großes Feld. Wie viele Strafpunkte kostet dann jede Position, ganz gleich, welches Token folgt?
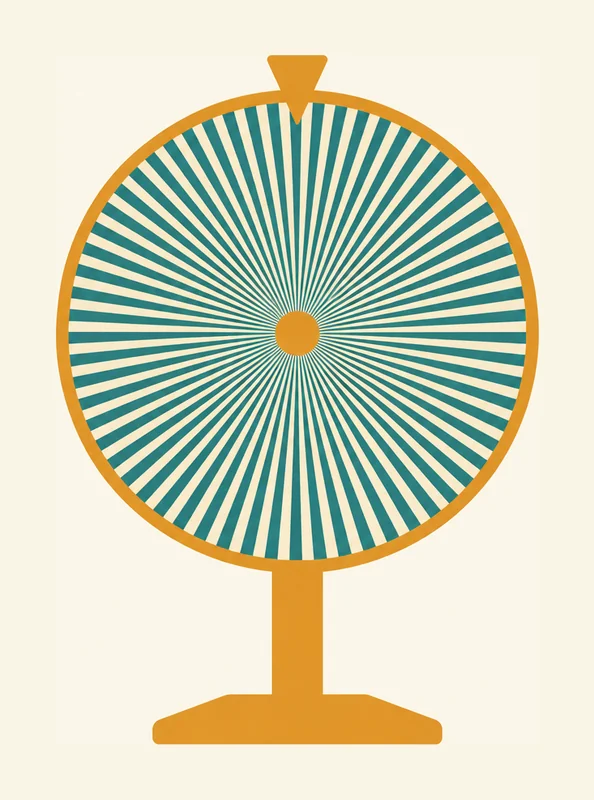
*Vor dem Training: ein Rad aus lauter gleich schmalen Feldern. Jedes Token kostet rund 11,9 Strafpunkte (schematisch).*
Es sind rund 11,9 Strafpunkte, etwa 17 Halbierungen von 100 Prozent bis zu einem winzigen Feld. Bei so einem Wert beginnt ein sorgfältig gestartetes Training. Der echte Satz liegt mit 4,8 weit darunter, bei gleichem Vokabular: Dort hat das Modell schon gelernt. Jedes Token bekommt hier dasselbe kleine Feld, egal wie der Satz weitergeht und welches Wort folgt. Das Rad weiß nichts über den Text, es rät nur. Ein gelerntes Modell verteilt seine Felder dagegen sehr ungleich, je nach Satz.
Das ältere GPT-2 von OpenAI hat ein deutlich kleineres Vokabular, rund 50.000 Tokens, und sein gleichmäßiges Rad kostet deshalb rund 10,8. Dasselbe Nichtwissen ergibt also je nach Vokabular verschiedene Zahlen.
Auch der Text zählt: Überraschende Wörter kosten viel, vorhersehbare wenig. Ein anderer Satz ergibt einen anderen Durchschnitt, und zwei Tokenizer zerschneiden denselben Text verschieden. **Loss-Werte lassen sich deshalb nur bei gleichem Tokenizer und gleichem Text direkt vergleichen.**
Ein Loss von 0,5 klingt nach „zur Hälfte falsch“. Das liegt nahe: Prozente gehen hinein, und viele Werte liegen zwischen 0 und 1. Doch der Loss ist kein Anteil.
Er hat keine Obergrenze: Je kleiner das Feld einer einzelnen Position wird, desto mehr Strafpunkte kostet sie.
Auch ein Durchschnitt kann 0,5 ergeben: aus einer sicheren Position mit 0 und einer mit rund einem Strafpunkt. Ohne Vergleichswert auf demselben Text sagt ein Loss wenig.
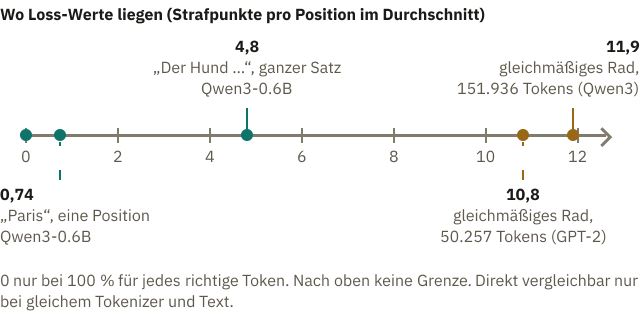
*Wo Loss-Werte liegen: 0 nur bei 100 Prozent für jedes richtige Token, der Wert eines gleichmäßigen Rads hängt vom Vokabular ab. Direkt vergleichbar sind Werte nur bei gleichem Tokenizer und gleichem Text.*
Ob etwas stimmt, misst der Loss nicht. Im Softmax-Baustein ging es um „Sydney“: Folgt in vielen Trainingstexten auf „Die Hauptstadt von Australien ist“ das Wort „Sydney“, kostet das umso weniger, je größer das Feld für „Sydney“ ist, obwohl Canberra die Hauptstadt ist. Ein kleiner Loss heißt also nur: gut vorhergesagt, was in den Trainingstexten steht. Darin liegt eine der Ursachen, warum ein Chatbot Falsches genauso glatt formulieren kann wie Richtiges.
Angenommen, im Trainingstext steht ein Tippfehler, etwa „Die Katze sitzt auf dem Sfoa“, und das Modell gibt an dieser Stelle „Sofa“ ein großes Feld. Wird diese Position teuer oder billig?
Teuer. Die Lösung unter der Karte ist der Tippfehler, und für ihn bleibt nur ein schmales Feld. Das Modell hat sinnvoll vorhergesagt und zahlt trotzdem.
Eine Ebene tiefer: Perplexität, der Loss als Zahl der Möglichkeiten
Forschungspapiere geben statt des Loss oft die **Perplexität** an, englisch perplexity, wörtlich Ratlosigkeit. Man rechnet sie aus dem durchschnittlichen Loss über einen Text:
`Perplexität = e hoch Loss`
e ist die Zahl 2,718…, die Grundzahl des natürlichen Logarithmus. Die Perplexität übersetzt den Loss in eine Zahl gleich guter Möglichkeiten. Ein Modell mit Perplexität 2 ist im Durchschnitt so unsicher, als hätte es an jeder Stelle die Wahl zwischen zwei gleich großen Feldern. Das Lehrbuch von Jurafsky und Martin nennt sie einen gewichteten durchschnittlichen Verzweigungsfaktor.
Für „Der Hund jagt die Katze“ mit 4,8 Strafpunkten im Durchschnitt ergibt das e hoch 4,8, rund 120: als hätte Qwen3-0.6B an jeder Stelle die Wahl zwischen gut hundert gleich großen Feldern. Ein gleichmäßiges Rad über 151.936 Tokens kommt auf genau 151.936, so viele Möglichkeiten, wie es Tokens gibt.
Der Loss sagt, wie weit das Modell danebenlag, aber nicht, woran es lag. Welcher der 0,6 Milliarden Parameter von Qwen3-0.6B hat wie viel zu den 4,8 beigetragen? Das klärt der nächste Baustein über Backpropagation, den Rückweg durch das Modell, und Gradienten, die Steigungen für jeden Parameter.
---
Quelle: https://ki-einfach-verstehen.de/de/bausteine/forward-pass-und-loss/