# Tokenizer: Wie Sprache zu Zahlen wird
Zeigt, wie ein Tokenizer Text in wiederverwendbare Stücke zerlegt, über ein festes Vokabular nummeriert und daraus den Zahlen-Input eines Sprachmodells macht.
Bevor du weiterliest, teile diesen Ausdruck im Kopf in Stücke: **„unwahrscheinlich"**. Würdest du daraus ein einziges Stück machen, drei verständliche Teile wie „un–wahr–scheinlich" oder jeden Buchstaben einzeln nehmen? Alle drei Varianten könnten einem Computer als Eingabe dienen. Sie führen aber zu sehr unterschiedlichen Listen von Zahlen — und genau diese Entscheidung trifft ein **[Tokenizer](https://ki-einfach-verstehen.de/de/glossar/tokenizer)**.
Im vorigen Baustein war der **[Input](https://ki-einfach-verstehen.de/de/glossar/input)** eines **[Sprachmodells](https://ki-einfach-verstehen.de/de/glossar/sprachmodell)** noch eine Folge von „Textstücken". Jetzt wird sichtbar, was zwischen deinem lesbaren Satz und diesem Modell-Input liegt: Der Text wird in Stücke zerlegt, und jedes Stück bekommt eine Nummer. Erst diese Folge ganzer Zahlen geht ins **[Modell](https://ki-einfach-verstehen.de/de/glossar/modell)**.
## Ein Modell bekommt keinen Text zu sehen
Auf deinem Bildschirm steht vielleicht „Die Katze sitzt." Für dich besteht diese Zeile aus Wörtern, Leerzeichen und einem Punkt. Das Modell braucht etwas anderes: eine feste Liste von Textstücken, die nicht weiterwächst. Den Grund kennst du aus dem vorigen Baustein: Ein Sprachmodell gibt für jedes Textstück, das es kennt, einen eigenen Score aus. Das geht nur, wenn feststeht, welche Textstücke es gibt und wie viele. Ein offener, beliebig langer Text muss deshalb zuerst in Stücke aus dieser festen Liste übersetzt werden.
Die Zerlegung bestimmt, wie lang der Input aus Sicht des Modells ist: Aus einem sichtbaren Wort können ein, zwei oder viele solcher Stücke werden. Sie heißen **[Tokens](https://ki-einfach-verstehen.de/de/glossar/token)**. Wie zerlegt wird, legt der Tokenizer fest, bevor das Modell rechnet.
Der Tokenizer versteht den Satz dabei nicht und wählt die Stücke nicht nach Gefühl aus. Er arbeitet nach festen Regeln. Derselbe Text ergibt mit demselben Tokenizer deshalb dieselbe Tokenfolge; nur beim Training lassen manche Verfahren absichtlich Zufall zu. Ein anderer Tokenizer darf denselben Satz anders zerlegen. Es gibt also nicht *die eine natürliche Tokenisierung*, die in der Sprache versteckt liegt.
## Warum nicht einfach jedes Wort nummerieren?
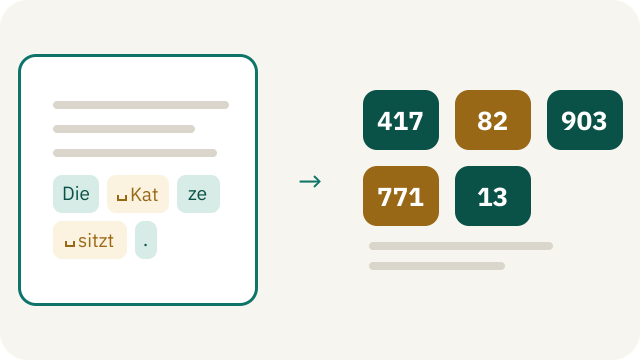
Die naheliegendste Idee lautet: Man nimmt ein Wörterbuch, gibt jedem Wort eine Nummer und ist fertig. „Die" könnte 417 sein, „Katze" 982 und „sitzt" 771. Für einen sorgfältig begrenzten Textbestand funktioniert das. Für offene Sprache wächst das Problem jedoch sofort.
Welche Einträge müsste die Liste enthalten? „Haus", „Haustür", „Haustürschlüssel", „Haustürschlüsselanhänger" und jede weitere deutsche Zusammensetzung? Dazu Namen, Produktbezeichnungen, Tippfehler, gebeugte Formen desselben Wortes wie „lernen", „lernt" und „gelernt" und Wörter, die morgen neu geprägt werden. Eine Liste kann groß werden, aber sie bleibt begrenzt. Sprache bildet weiter neue Zeichenfolgen.
Man könnte unbekannte Wörter durch einen einzigen Platzhalter ersetzen. Dann sähe das Modell jedoch zwischen zwei völlig verschiedenen neuen Namen oder Fachbegriffen keinen Unterschied mehr: Beide würden auf dasselbe Symbol „unbekannt" schrumpfen. Ein Chatbot sähe dann bei jedem neuen Namen, etwa dem einer gerade gegründeten Band, nur „unbekannt".
## Warum nicht jeden Buchstaben einzeln nehmen?
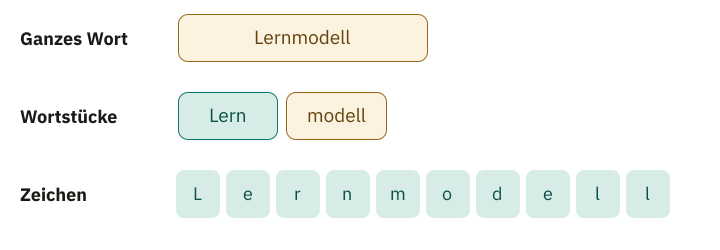
Am anderen Ende liegt eine ebenso einfache Lösung: Jeder Buchstabe und jedes Satzzeichen wird ein eigenes Token. Damit lässt sich fast jedes Wort zusammensetzen, auch ein völlig neues. Die Liste der möglichen Stücke bleibt klein. „Katze" benötigt dann allerdings fünf Tokens statt vielleicht einem oder zwei.
Jedes Token belegt einen eigenen Platz in der Eingabe, eine sogenannte Position. In einem langen Dokument vervielfacht sich so die Zahl der Positionen, die das Modell verarbeiten muss. Der Satz „Die Katze sitzt." hätte inklusive Leerzeichen und Punkt bereits 16 einzelne Zeichenpositionen. Bei einzelnen Zeichen bräuchte ein Chatbot außerdem für jeden Buchstaben seiner Antwort eine eigene Runde der Textschleife. Eine gröbere Zerlegung käme mit deutlich weniger Tokens aus.
Einzelne Zeichen tragen zudem sehr wenig auf einmal. Das Modell müsste häufige Folgen wie „sch", „ung" oder „tion" immer wieder aus vielen Positionen zusammensetzen, obwohl sie in Texten ständig gemeinsam auftreten. Ganze Wörter sind zu grob und unflexibel; einzelne Zeichen sind flexibel, aber oft unnötig kleinteilig. Gesucht ist ein brauchbarer Mittelweg.
## Der brauchbare Mittelweg: wiederverwendbare Wortstücke

Viele moderne Text-Tokenizer arbeiten deshalb mit **[Subword-Tokens](https://ki-einfach-verstehen.de/de/glossar/subword-token)**: Ein Token kann ein ganzes häufiges Wort sein, aber ebenso ein wiederkehrender Wortteil oder ein einzelnes Zeichen. Das funktioniert wie ein Baukasten: Häufiges liegt als großes fertiges Stück bereit, Seltenes setzt du aus kleinen Teilen zusammen. So arbeiten auch die Tokenizer hinter bekannten Chatbots wie ChatGPT. Das Wort „Lernmodell" könnte beispielsweise in „Lern" und „modell" zerfallen. Das ist nur ein Denkbeispiel; ein anderer Tokenizer könnte „L", „ern", „mod", „ell" wählen oder das ganze Wort kennen.
Welche Stücke existieren, hängt vom Textmaterial und vom Verfahren ab, mit dem das **[Vokabular](https://ki-einfach-verstehen.de/de/glossar/vokabular)** erzeugt wurde, also die feste Liste aller Stücke, die ein Tokenizer kennt. Und „unwahrscheinlich" vom Anfang? Ein Subword-Tokenizer nähme vermutlich weder das ganze Wort noch jeden Buchstaben, sondern zwei oder drei häufige Stücke. Welche, entscheidet sein gelerntes Vokabular, nicht die Silbenlehre. Weil sich notfalls fast jedes Wort aus einzelnen Zeichen zusammensetzen lässt, braucht ein solcher Tokenizer den Platzhalter „unbekannt“ nur noch selten.
Dieser Mittelweg löst nicht jedes Problem perfekt. Ein häufiges Muster ist kurz dargestellt; eine seltene Schreibweise kann in viele kleine Teile zerfallen. Dadurch ist die Zahl der Tokens nicht einfach die Zahl der Wörter. Zwei Sätze mit ähnlich vielen sichtbaren Zeichen können unterschiedlich viele Tokens benötigen. Selbst Großschreibung, Leerzeichen oder ein Akzent können die Aufteilung ändern, wenn dadurch andere Einträge passen.
Woher kommen die Stücke? Anders als beim Baukasten hat sie sich niemand ausgedacht. Sie werden aus großen Textmengen gelernt: Ein Verfahren zählt, welche Zeichen oft nebeneinanderstehen, und fügt sie schrittweise zu größeren Stücken zusammen. Wie das genau geht, steht weiter unten unter „Eine Ebene tiefer“.
## Token, Tokenizer und Vokabular sauber trennen
Woher weiß der Tokenizer eigentlich, dass es „ Kat" als Stück gibt und „Kaz" nicht? Dafür braucht es drei Dinge, die man leicht verwechselt. Ein **Token** ist eine einzelne Einheit, zum Beispiel „ Kat" (mit Leerzeichen davor, dazu gleich mehr), „ze" oder „.". Das **Vokabular**, die feste Liste aller Stücke, ordnet jeder erlaubten Einheit eine ID zu. Der **[Tokenizer](https://ki-einfach-verstehen.de/de/glossar/tokenizer)** ist das Verfahren samt Regeln und Vokabular, das Text in diese Einheiten zerlegt und die Einheiten wieder zu Text zusammensetzt.
Du kannst dir das Vokabular wie eine Kartei vorstellen. Auf jeder Karte stehen ein Textstück und eine Kennnummer. Der Tokenizer nimmt deinen Satz, sucht eine passende Folge von Karten und gibt deren Nummern aus. Beim Rückweg schlägt er die Nummern nach und fügt die Textstücke wieder zusammen. Beide Richtungen laufen bei jeder Chatbot-Nachricht: hin mit deiner Frage, zurück mit jedem Stück der Antwort.
Das Denkbild hat eine Grenze: Der Tokenizer sucht nicht beliebig nach „inhaltlich passenden" Karten. Seine Zerlegungsregeln bestimmen eindeutig, welche Folge gewählt wird. Und die Karte mit „Kat" enthält keine gespeicherte Definition einer Katze. Sie enthält zunächst nur eine Zeichenfolge. Was das Modell später mit dieser Karte verbindet, entsteht erst durch seine trainierten **[Parameter](https://ki-einfach-verstehen.de/de/glossar/parameter)**.
## Eine ID ist ein Etikett, keine Bedeutung
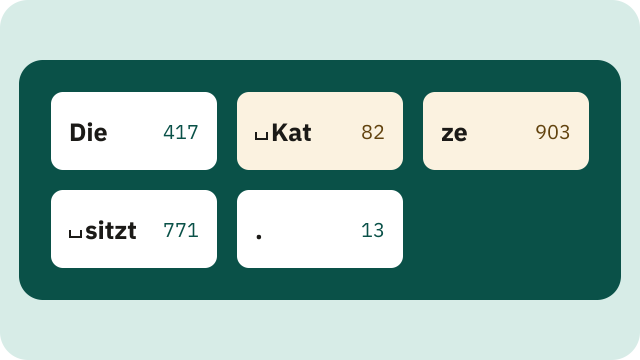
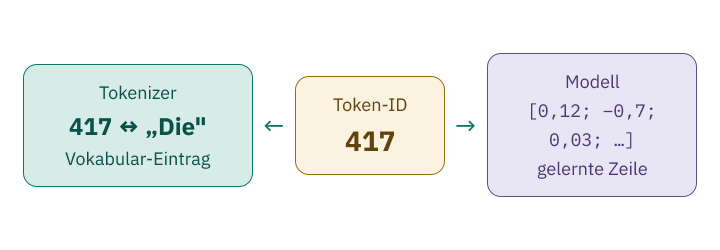
Sobald ein Textstück im Vokabular steht, erhält es eine ganze Zahl, seine **[Token-ID](https://ki-einfach-verstehen.de/de/glossar/token-id)**. Angenommen, „Die" trägt die ID 417. Diese Zahl ist keine Übersetzung des Wortes in Mathematik. Sie misst weder Bedeutung noch Häufigkeit, Stimmung oder Wichtigkeit. Sie ist nur die Nummer auf einer Karteikarte. Die 417 sagt nichts darüber, was auf der Karte steht; erst das Nachschlagen in der Kartei stellt die Verbindung her. Dass ein Chatbot „Die" sinnvoll weiterführt, liegt also nicht an der 417, sondern an dem, was sein Modell dazu gelernt hat.
Darum ist eine Token-ID ohne Angabe des Tokenizers nicht eindeutig. In einem anderen Vokabular kann 417 für „und", einen Teil eines Wortes oder ein Sonderzeichen stehen. Mit den IDs zu rechnen, als wären sie Größenwerte, wäre ebenfalls sinnlos: ID 417 plus ID 82 ergibt nicht die Bedeutung von ID 499. Im Modell dient dieselbe Nummer als Adresse für eine Liste gelernter Zahlen.
## Ein vollständiges Spielzeugbeispiel
Betrachte ein erfundenes Mini-Vokabular. Die Zahlen dienen nur dazu, den Ablauf sichtbar zu machen; ein realer Tokenizer zerlegt anders.
| Token-ID | Textstück |
| ---: | :--- |
| 417 | „Die" |
| 82 | „ Kat" |
| 903 | „ze" |
| 771 | „ sitzt" |
| 13 | „." |
Beim **[Kodieren](https://ki-einfach-verstehen.de/de/glossar/tokenizer)** erhält der Tokenizer den Text „Die Katze sitzt.". Mit diesem Mini-Vokabular gibt es genau eine Zerlegung: „Die" + „ Kat" + „ze" + „ sitzt" + „.", denn ein Stück „ Katze" steht nicht in der Liste. Durch Nachschlagen im Vokabular entsteht die Folge 417, 82, 903, 771, 13. Diese fünf Zahlen bekommt das Modell als Eingabe.
Beim **[Dekodieren](https://ki-einfach-verstehen.de/de/glossar/tokenizer)** läuft die Zuordnung rückwärts. Der Tokenizer schlägt jede ID nach, erhält die fünf gespeicherten Textstücke und fügt sie in derselben Reihenfolge zusammen. Weil die Leerzeichen schon am Anfang zweier Tokens gespeichert sind, entsteht wieder „Die Katze sitzt.". Ein zusätzlich eingefügtes Leerzeichen würde das Ergebnis verändern.
Das Beispiel zeigt auch, warum die Reihenfolge zählt. 417, 82, 903 ist „Die Katze"; 82, 903, 417 ergibt „ KatzeDie". Die IDs bilden eine Folge, deren Reihenfolge erhalten bleibt. Genau an solchen Folgen lernt ein Sprachmodell später, welches Token nach den bisherigen gut passen könnte.
## Leerzeichen und Satzzeichen gehören zur Eingabe
Menschen behandeln Leerzeichen oft wie leeren Zwischenraum. Für einen Tokenizer sind sie Zeichen wie alle anderen. Manche Vokabulare führen häufige Wörter mit einem vorangestellten Leerzeichen als eigenen Eintrag. Dadurch kann „Katze" am Satzanfang anders zerlegt werden als „ Katze" in der Satzmitte. Auch Zeilenumbrüche, Tabs, Anführungszeichen oder Satzzeichen können eigene Tokens sein oder in größere Einheiten eingehen. Kopierst du eine Tabelle mit vielen Leerzeilen in einen Chatbot, werden auch diese Zeichen zu Tokens.
Welche Zahlen dabei herauskommen, legt allein das Vokabular dieses einen Tokenizers fest. Was passiert, wenn ein Modell mit dem falschen Vokabular gefüttert wird?
## Warum Tokenizer und Modell ein festes Paar sind
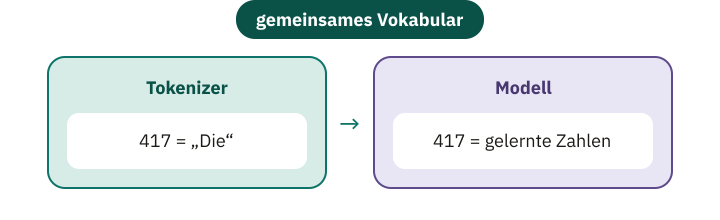
Das Modell wurde mit genau einer bestimmten Zuordnung trainiert. Wenn seine Eingabe 417 lautet, greifen seine Parameter auf die Liste gelernter Zahlen zurück, die während des Trainings für Eintrag 417 angepasst wurde. Tauscht man nur den Tokenizer aus, bekommt das Modell formal gültige Zahlen, aber die falschen Symbole. Es ist, als hätte jemand die Nummern auf den Karteikarten neu verteilt: Unter 417 steht jetzt „und“, das Modell erwartet aber, was es für „Die“ gelernt hat.
Auch die Größe des Vokabulars muss passen, sonst erzeugt der Tokenizer IDs, für die das Modell gar keinen Eintrag besitzt. Deshalb werden Tokenizer-Dateien, Vokabular, Regeln und Spezial-Tokens gemeinsam mit einem Modell ausgeliefert und versioniert. Deshalb kommt mit einem neuen Chatbot-Modell oft auch ein eigener Tokenizer, und derselbe Satz ergibt dort andere IDs.
Eine Ebene tiefer: Wozu ein Vokabular Spezial-Tokens enthält
Neben Textstücken enthält ein Vokabular oft auch **Spezial-Tokens**. Sie stehen nicht für Text, sondern für Struktur. Ein echtes Beispiel ist GPT-2, ein frühes Sprachmodell von OpenAI. Sein Vokabular hat 50.257 Einträge mit den IDs 0 bis 50256. Der letzte Eintrag, ID 50256, heißt `<|endoftext|>`. Er dient bei GPT-2 zugleich als Anfangs- und als Endmarke einer Textfolge. Erzeugt das Modell diese ID, weiß das Programm drumherum: Der Text ist fertig.
Chatbots brauchen mehr solcher Marken, denn ein Gespräch hat Rollen. Im Gesprächsformat „Harmony“ für OpenAIs frei verfügbare gpt-oss-Modelle beginnt jede Nachricht mit `<|start|>`. Danach folgt die Rolle, etwa `user` für dich oder `assistant` für das Modell. `<|message|>` leitet den eigentlichen Inhalt ein, `<|end|>` schließt die Nachricht ab. Auch diese Marken sind nummerierte Einträge, bei gpt-oss mit IDs um 200.000, in einem viel größeren Vokabular als dem von GPT-2. So sieht das Modell in einer einzigen langen Tokenfolge, wer was gesagt hat.
Ein Detail schützt dieses System. Tippst du die Zeichenfolge `<|endoftext|>` selbst ein, soll daraus nicht die ID 50256 des Spezial-Tokens werden, sonst könnte jemand dem Modell gefälschte Marken unterschieben. Wer Programme mit OpenAIs Zerlegewerkzeug tiktoken baut, muss sich deshalb entscheiden: Standardmäßig bricht tiktoken bei dieser Zeichenfolge mit einem Fehler ab. Auf Wunsch zerlegt es sie wie gewöhnlichen Text, dann in sieben ganz normale Tokens statt in das eine Spezial-Token.
Eine Ebene tiefer: Wie BPE sein Vokabular lernt
**Byte Pair Encoding**, kurz **[BPE](https://ki-einfach-verstehen.de/de/glossar/byte-pair-encoding)**, war ursprünglich ein Verfahren zur Datenkompression. Für die maschinelle Übersetzung wurde es so angepasst, dass es seltene und unbekannte Wörter als Folgen kleinerer Einheiten darstellt, statt sie zu verwerfen. Ganz ohne Platzhalter kommt ein Tokenizer erst aus, wenn er bis auf Bytes hinuntergeht. Ein **Byte** ist ein kleiner Zahlenbaustein im Computerspeicher; jedes sichtbare Zeichen wird durch ein oder mehrere Bytes dargestellt, ein Umlaut oder Emoji durch mehrere. Weil es nur 256 verschiedene Bytes gibt, passen alle ins Vokabular. Selbst ein nie gesehenes Schriftzeichen lässt sich so zusammensetzen, und die Buchstabenfolge eines neuen Namens bleibt erhalten.
BPE beginnt mit kleinen digitalen Einheiten. Das können je nach Variante Zeichen oder Bytes sein. Dann zählt das Verfahren, welche benachbarten Paare im Trainingsmaterial besonders häufig vorkommen. Das häufigste Paar wird zu einer neuen gemeinsamen Einheit verschmolzen; darauf bezieht sich „Pair Encoding". Dieser Vorgang wird wiederholt, bis die gewünschte Vokabulargröße oder Zahl von Zusammenführungen erreicht ist.
Stehen im Material etwa häufig die Folgen „l e r n e n", „l e r n t" und „g e l e r n t", könnten zunächst häufige Buchstabenpaare und später größere Folgen wie „lern" zu einer Einheit werden. Seltene Endungen bleiben aus kleineren Teilen zusammensetzbar.
Bei der Anwendung spielt der Tokenizer die gelernten Zusammenführungen in derselben Reihenfolge auf den neuen Text ab; deshalb ergibt derselbe Text dieselbe Zerlegung. BPE ist nicht das einzige Subword-Verfahren. **[SentencePiece](https://ki-einfach-verstehen.de/de/glossar/sentencepiece)** lernt Subword-Modelle, darunter BPE, direkt aus unveränderten Sätzen, ohne sie vorher an vermuteten Wortgrenzen zu zerlegen. Das hilft bei Sprachen, die Wortgrenzen nicht wie das Deutsche mit Leerzeichen markieren. Der gemeinsame Gedanke bleibt: Eine begrenzte Menge gelernter Einheiten soll beliebige Eingaben möglichst brauchbar darstellen.
## Warum du Tokens im Alltag bemerkst
In einem langen Chat mit einem KI-Assistenten scheint das Modell irgendwann zu vergessen, was ganz am Anfang stand. Oder ein Dienst meldet, dein Text sei zu lang, obwohl er nur wenige Seiten hat. In beiden Fällen geht es nicht um Wörter, sondern um Tokens.
Modelle verarbeiten nur eine begrenzte Zahl von Tokenpositionen auf einmal, weil Speicherplatz und Rechenarbeit begrenzt sind. Dieses **[Kontextfenster](https://ki-einfach-verstehen.de/de/glossar/kontextfenster)** umfasst je nach System Eingabe und erzeugte **[Ausgabe](https://ki-einfach-verstehen.de/de/glossar/output)**. Du kennst den Grund für das Vergessen aus dem vorigen Baustein: In einem Chat geht bei jeder Runde der ganze bisherige Verlauf erneut als Input ins Modell, und er wird mit jeder Antwort länger. Passt er nicht mehr hinein, muss das System einen Teil weglassen, kürzen oder in mehreren Schritten verarbeiten.
Manche Texte zerfallen dabei in besonders viele kleine Tokens: eine ungewöhnliche Produktkennung, eine lange Zahlenreihe oder eine Sprache, die das Vokabular weniger kompakt abdeckt. Solche Texte verbrauchen mehr Positionen als ein gleich langer geläufiger Text. Viele Anbieter rechnen außerdem pro Token ab. Faustformeln wie „ein Token sind ungefähr vier Zeichen" geben nur eine grobe Vorstellung. Für eine konkrete Grenze oder Kostenabschätzung zählst du deshalb mit dem Zählwerkzeug des Anbieters, nicht mit einer Zeichenformel.
## Was der Tokenizer nicht leistet
Der Tokenizer erkennt weder Wortbedeutungen noch grammatische Bausteine noch die Absicht eines Satzes. Manchmal sehen seine Grenzen sprachlich sinnvoll aus — etwa „Lern" und „modell". Das kann daran liegen, dass solche Zeichenfolgen im Trainingsmaterial häufig waren; eine linguistisch korrekte Analyse ist es nicht. Ein Token darf mitten durch eine Silbe, Endung oder einen Namen verlaufen.
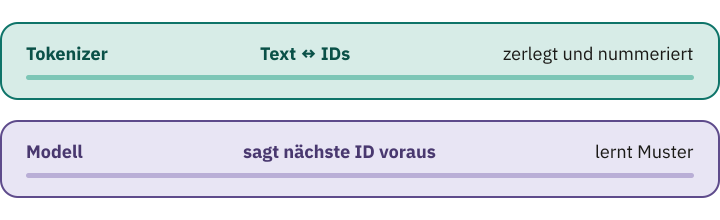
Der Tokenizer entscheidet auch nicht, welches Token als Nächstes kommt. Er wandelt vorhandenen Text in IDs um und erzeugte IDs wieder in Text zurück. Die Vorhersage geschieht im Modell.
Ein verbreiteter Irrtum lautet: Ein Modell „versteht" ein Wort, wenn es dafür einen einzelnen Token gibt; zerfällt das Wort in viele Tokens, versteht es das Wort schlechter oder gar nicht. Das klingt plausibel, weil eine kompakte Einheit vollständiger wirkt als mehrere Bruchstücke.
Tatsächlich hat das Modell während des Trainings Muster über ganze Folgen von Tokens gelernt und kann Informationen aus mehreren Positionen zusammensetzen. Ob ein Wort aus einem oder mehreren Tokens besteht, beschreibt zunächst nur seine technische Darstellung. Von der Tokenzahl kannst du deshalb nicht auf Verständnis schließen. Folgenlos ist die Zerlegung trotzdem nicht: Bei manchen Aufgaben, etwa beim Rechnen mit mehrstelligen Zahlen, hängt die Leistung messbar davon ab, wie die Ziffern in Tokens aufgeteilt werden.
## Die Zahlen sind erst der Anfang
Der vollständige Weg bis hierhin lautet nun: sichtbarer Text → Tokenizer-Regeln → Tokenfolge → Nachschlagen im Vokabular → Folge von Token-IDs. Damit ist der Text nummeriert, aber noch nicht in einer Form, mit der das **[Modell](https://ki-einfach-verstehen.de/de/glossar/modell)** sinnvoll Ähnlichkeiten und Beziehungen berechnen kann.
Im nächsten Schritt dient jede ID als Adresse für eine lange Liste gelernter Zahlen. Damit stellen sich neue Fragen: Was genau ist eine solche Zahlenliste, und wie ordnet man viele davon, für jedes Token im Satz eine? Darum geht es im nächsten Baustein: Skalar, **[Vektor](https://ki-einfach-verstehen.de/de/glossar/vektor)**, Matrix und **[Tensor](https://ki-einfach-verstehen.de/de/glossar/tensor)**.
Wenn du dir nur einen Satz merkst, dann diesen: **Ein Token ist ein wiederverwendbares Textstück, seine ID ist nur die Nummer im Vokabular, und erst das Modell verbindet diese Nummer mit einer Liste gelernter Zahlen.**
---
Quelle: https://ki-einfach-verstehen.de/de/bausteine/tokenizer-ids-vokabular/