Baustein 6 von 9 · GrundlagenGelesen
Wahrscheinlichkeit und Softmax: Wie ein Modell sich entscheidet
Wie ein Sprachmodell aus seinen Scores Anteile macht, warum es mal das Naheliegende und mal etwas anderes wählt und was die Temperatur daran ändert.
Lässt du einen Chatbot eine Antwort neu erzeugen, bekommst du oft eine andere, obwohl deine Frage gleich geblieben ist. Wie du aus dem Baustein über Input und Output weißt, berechnet das Modell bei gleichem Input im Prinzip jedes Mal dieselbe Score-Liste. Sie bewertet für jedes Token (ein Textstück), wie gut es als Nächstes passt. Erst in einem anschließenden Schritt wird ein Token ausgewählt – und dabei kommt der Zufall ins Spiel. Scores wie 7,1 oder −2,3 sind noch keine Wahrscheinlichkeiten. Wie wird daraus entschieden, welches Token als Nächstes folgt?
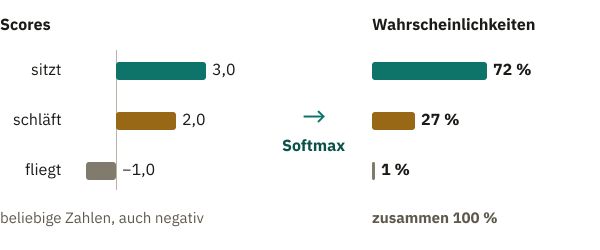
Du tippst „Die Katze“. Für dieses Beispiel nehmen wir nur drei mögliche Fortsetzungen an: „sitzt“ mit dem Score 3,0, „schläft“ mit 2,0 und „fliegt“ mit −1,0. Diese Scores sind ausgedacht. Ein Mensch hat sie gesetzt, trainiert wurde nichts. Ein echtes Modell vergibt einen Score an jedes Token seines Vokabulars (die feste Liste aller Stücke, in die das Modell einen Text zerlegt), zum Beispiel das ältere GPT-2, ein Vorläufer der Modelle hinter ChatGPT, an rund 50.000 Tokens. Es berechnet jeden Score aus seinen Parametern, den Zahlen, die das Training eingestellt hat. Mit diesen ausgedachten Scores lässt sich nur die Auswahl eines Tokens durchrechnen. Welche Fortsetzung ein echtes Modell nach „Die Katze“ bevorzugt, lässt sich daraus nicht ablesen.
Wie oft soll „sitzt“ drankommen?
Angenommen, das Modell soll nach „Die Katze“ hundertmal das nächste Token wählen. Wie oft sollte dabei „sitzt“ kommen und wie oft „fliegt“? Versuch es kurz aus den Scores abzulesen, bevor du weiterliest.
Nimmt der Auswahlschritt wie im Baustein über Input und Output immer den höchsten Score, kommt hundertmal „sitzt“, und Neu-Erzeugen brächte im Prinzip nichts anderes. Soll auch „schläft“ manchmal drankommen, sagen die Scores nicht, wie oft. Bei „fliegt“ hakt es: Sein Score ist negativ, und einen Anteil von minus einem Prozent gibt es nicht. Ein Score zeigt nur, welches Token vorn liegt und um wie viel, nicht, wie oft es drankommen soll.
Wie bei einem Glücksrad bekommt jedes Token ein Feld, dessen Größe angibt, wie oft es bei sehr vielen Versuchen drankommt. Je größer ein Feld, desto öfter bleibt der Zeiger dort stehen. Ein Feld mit einem Viertel des Rads bleibt im Schnitt bei jeder vierten Drehung stehen. Der Anteil eines Felds am Rad heißt Wahrscheinlichkeit. Das Wort meint hier nur diese Größe, nicht, wie sicher sich das Modell ist. Sie liegt immer zwischen 0 und 100 Prozent, nie darüber oder darunter.
Alle Anteile zusammen ergeben genau 100 Prozent. Diese Liste heißt Verteilung.
Für jedes nächste Token braucht ein Chatbot so ein Rad. Wie baut man also aus 3,0, 2,0 und −1,0 ein Rad?
Aus Punkten werden Anteile: Softmax
Nach einem Quizabend hängt die Punktetafel an der Wand. Team A hat 30 Punkte, Team B 20, Team C 10. Team A hat also die Hälfte aller Punkte.
Bei den Scores geht das schief: Teilt man jeden Score durch die Summe aller Scores, bekommt „fliegt“ einen negativen Anteil, also minus ein Viertel. Ein Feld, das kleiner ist als nichts, passt auf kein Rad.
Deshalb macht Softmax aus jedem Score zuerst eine positive Zahl, die Stärke. Die Stärke spielt die Rolle der Punkte: Jedes Token ist ein Team. Negative Punkte gibt es hier nicht.
Diese Regel ist fest und wird nicht trainiert. Ein Score von null bekommt die Stärke 1. Jeder Punkt darüber macht die Stärke 2,718-mal so groß, jeder Punkt darunter teilt durch 2,718. Dann zählt Softmax die Stärken zusammen und teilt jede durch die Summe, wie ein Team seine Punkte durch die Gesamtpunktzahl.
Diese Zahl heißt e, eine feste Zahl der Mathematik, die niemand gewählt hat.
Für „sitzt“ sind es drei Punkte über null, also e · e · e. „schläft“ hat zwei Punkte, „fliegt“ liegt einen Punkt unter null.
Die drei Stärken ergeben zusammen 27,8; die Zahlen dazu stehen in der Box „Die Formel hinter Softmax“. Teilt man jede Stärke durch diese Summe, bekommt „sitzt“ rund 72 Prozent, „schläft“ rund 27 und „fliegt“ rund 1 Prozent. Diese Rechnung heißt Softmax. Sie macht aus jeder Score-Liste ein Rad.
Zähl zu allen drei Scores zehn dazu: Dann stehen dort 13,0, 12,0 und 9,0. Überleg kurz: Werden die Prozente dann größer, kleiner oder bleiben sie gleich?
Sie bleiben genau gleich. Zehn Punkte mehr machen jede Stärke gleich viel größer, die Summe wächst genauso. Beim Teilen fällt dieser Faktor wieder heraus. Eine ganze Liste kann höher oder tiefer liegen, etwa nach einem anderen Satzanfang. Hier endet das Bild der Punktetafel: Auf der Tafel würden zehn Punkte für jedes Team die Anteile verschieben, bei Scores nicht. Bei Scores zählt nur, wie weit sie auseinanderliegen.
Auf dem Rad bekommt der höchste Score immer das größte Feld. Jeder Punkt, um den ein Score vor den anderen liegt, vervielfacht seine Stärke. Bei einem Punkt ist sie etwa 2,7-mal so groß, bei zwei Punkten gut siebenmal so groß. Liegt ein Token weit vor allen anderen, bekommt es deshalb fast das ganze Rad. Softmax gibt jedem Token einen Anteil über null: Selbst „fliegt“ behält rund 1 Prozent.
Dieselbe Rechnung bei der Bilderkennung
Die Bilderkennung aus dem Baustein über Input und Output rechnet meist genauso. Sie gibt für ein Foto Scores aus: Katze 6,2, Hund 2,9, Fuchs 1,4 und Auto −3,0.
Die Katze liegt gut drei Punkte vor dem Hund und bekommt deshalb fast das ganze Rad. Hund, Fuchs und Auto teilen sich den Rest; das Auto bekommt nur einen winzigen Anteil, der aber größer als null ist. Bei einem Sprachmodell wie GPT-2, einem Vorläufer der Modelle hinter ChatGPT, läuft dieselbe Rechnung vor jedem neuen Token, mit allen Scores seines Vokabulars. Das Prinzip bleibt dasselbe, egal ob die Liste Tiere oder Wörter enthält.
Eine Ebene tiefer: Die Formel hinter Softmax
Die Stärke eines Scores ist die Zahl e hoch dem Score. Bei ganzen Zahlen oben zeigt die kleine Zahl, wie oft e mit sich selbst multipliziert wird: e³ = e · e · e ≈ 20,1 und e² = e · e ≈ 7,4. Eine negative ganze Zahl oben heißt teilen: e⁻¹ = 1 : e ≈ 0,37. Bei Hochzahlen mit Komma hilft ein Taschenrechner mit der Taste eˣ. Und e⁰ ist 1, genau wie in der Regel oben. Die Summe der drei Stärken ist 20,086 + 7,389 + 0,368 ≈ 27,84; jede Stärke durch diese Summe geteilt ergibt die Anteile oben. Als Formel für den Kandidaten Nummer i:
Softmax(xᵢ) = eˣⁱ / Σⱼ eˣʲ
Über dem Bruchstrich steht die Stärke des Kandidaten, darunter die Summe aller Stärken, gekennzeichnet durch das Summenzeichen Σ.
Bei der Bilderkennung ergibt e hoch 6,2 rund 493 (Katze), e hoch 2,9 rund 18 (Hund), e hoch 1,4 rund 4 (Fuchs) und e hoch −3,0 rund 0,05 (Auto). Zusammen rund 515, davon 493 für die Katze: rund 96 Prozent.
Der Name kommt von der harten Regel „nimm den Größten“ (englisch max). Softmax ist ihre weiche Version: Der Größte bekommt am meisten, die anderen behalten etwas, und je größer der Vorsprung, desto näher kommt Softmax der harten Regel. In der Fachsprache heißen die Scores vor Softmax Logits.
Den Favoriten nehmen oder das Rad drehen
Softmax hat das Rad gebaut: „sitzt“ hat 72 Prozent, „schläft“ 27 Prozent, „fliegt“ einen schmalen Streifen. Gewählt ist damit noch nichts. Im Baustein über Input und Output nahm der Auswahlschritt einfach das Token mit dem höchsten Score. Das Rad wird dabei gar nicht gedreht; stattdessen wird direkt das größte Feld gewählt. Diese Auswahl heißt Greedy-Auswahl (englisch greedy, gierig: sie greift immer nach dem größten Happen). Weil Softmax die Reihenfolge nicht ändert, gehört das größte Feld immer dem höchsten Score. Für die Greedy-Auswahl bräuchte es Softmax also gar nicht.
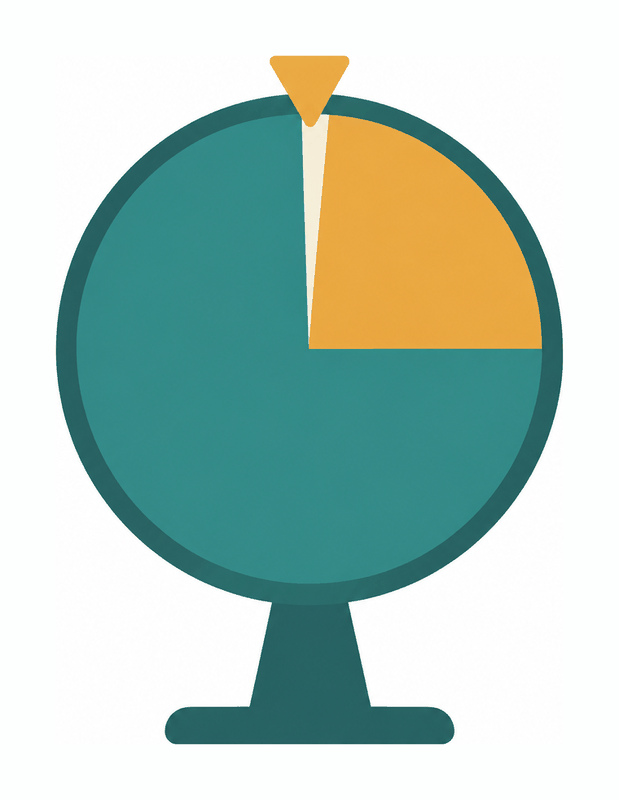
Erst für die Auswahl mit Zufall braucht es das Rad. Es wird wirklich gedreht, und das Token unter dem Zeiger kommt dran. Diese Auswahl heißt Sampling, nach dem englischen Wort für „Stichprobe“: Aus den möglichen Tokens wird eines gezogen. Zufall klingt nach einem fairen Würfel. Müsste „fliegt“ dann genauso oft drankommen wie „sitzt“? Beim Drehen zählt die Größe: Große Felder kommen oft, schmale selten. Bei 100 Drehungen landet der Zeiger im Schnitt ungefähr 72-mal auf „sitzt“, 27-mal auf „schläft“ und einmal auf „fliegt“. Mit Sampling unterscheiden sich Antworten deshalb von Mal zu Mal. Beliebig wird dabei nichts, weil die großen Felder weiterhin öfter drankommen.
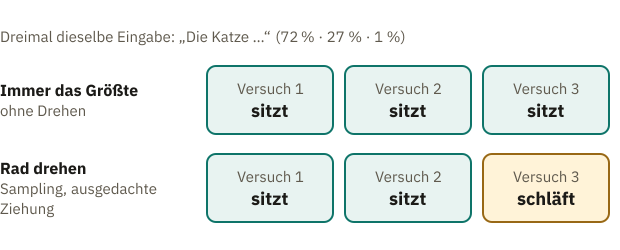
Warum nimmt ein Chatbot dann nicht immer das größte Feld? Bei kurzen Antworten wie einer Zahl geht das gut. Längere Texte, die immer nur die wahrscheinlichste Fortsetzung wählen, werden fade und wiederholen leicht dieselben Wendungen. Sampling bringt Abwechslung hinein, weil gelegentlich auch das zweit- oder drittbeste Token drankommt.
Ein Rad gilt immer nur für ein Token. Vor jedem neuen Token berechnet das Modell eine neue Score-Liste. Softmax baut daraus ein neues Rad, das genau einmal gedreht wird. Das gewählte Token wird angehängt, und die Schleife beginnt von vorn.
Lässt du eine Antwort neu erzeugen, werden alle Räder noch einmal gedreht. Bleibt der Zeiger beim ersten Rad aber woanders stehen, etwa bei „schläft“ statt „sitzt“, hängt das gewählte Token am Text, und alle folgenden Runden rechnen mit ihm weiter. So entsteht auf dieselbe Frage eine andere Antwort.
Probier es aus: Lass eine kurze Antwort drei-, viermal neu erzeugen und achte darauf, ab welchem Wort sich die Fassungen trennen.
Die drei Felder sind eine Vereinfachung. Ein echtes Rad hat ein Feld für jedes Token des Vokabulars. Die allermeisten Felder wären so schmal, dass man sie kaum sehen könnte. Wie stark der Zufall beim Drehen wirkt, lässt sich einstellen.
Mehr oder weniger Zufall: die Temperatur
Aufgaben vertragen unterschiedlich viel Zufall. Soll ein Programm aus einer Mail immer dasselbe Datum herauslesen, stört jede Abweichung. Bei zehn Vorschlägen für einen Titel ist Abwechslung erwünscht. Wer ein Sprachmodell aus einem eigenen Programm heraus nutzt, kann bei vielen Modellen mit jeder Anfrage einen Wert namens Temperatur mitschicken. Die Temperatur wirkt erst im Auswahlschritt. Dort werden die Scores durch die Temperatur geteilt, und erst daraus berechnet Softmax die Anteile. Bei Temperatur 1 bleiben die Anteile wie oben.
Bei Temperatur 0,5 wird durch 0,5 geteilt, das heißt: mal zwei. Die Scores werden also verdoppelt, und alle Abstände werden doppelt so groß.
Aus „sitzt“ mit drei wird sechs, aus „schläft“ mit zwei wird vier.
Jetzt liegt „sitzt“ zwei Punkte vor „schläft“. Weil jeder Punkt die Stärke vervielfacht, ist „sitzt“ gut siebenmal so stark.
Nimmt man „schläft“ als einen Teil, ist „sitzt“ sieben Teile; zusammen sind das acht. Sieben von acht Teilen sind rund 88 Prozent für „sitzt“, rund 12 für „schläft“, und „fliegt“ bleibt praktisch leer.
Bei Temperatur 2 werden die Scores halbiert. Überleg, was dann mit dem schmalen Feld von „fliegt“ passiert.
Live-Demo · zum Ausprobieren
Dreh das Glücksrad
Ausgedachte SimulationOben stehen die Scores für „Die Katze …“, darunter das Rad, das Softmax daraus baut. Die Temperatur lässt sich verschieben, das Rad einmal oder gleich hundertmal drehen.
Bei Temperatur 1 landet das Rad in 100 Drehungen etwa einmal auf „fliegt“. Schätz zuerst, wie oft es bei Temperatur 2 sein wird. Dann stell die Temperatur auf 2 und dreh 100-mal.
Scores (ausgedacht) · Die Katze …
Rechenweg und eigene Scores
Nach Softmax: Wahrscheinlichkeiten
Der dünne Balken unter jedem Anteil zählt mit, wie oft das Rad dort gelandet ist.
Auflösung
Etwa achtmal statt einmal; einzelne Runden schwanken. Durch 2 geteilt schrumpfen alle Abstände auf die Hälfte. „fliegt“ liegt dann nur noch zwei statt vier Punkte hinter „sitzt“, und weil jeder Punkt Abstand die Stärke durch etwa 2,7 teilt, wächst sein Feld von rund 1 auf rund 8 Prozent. Die Scores selbst bleiben dieselben. Bei einem echten Chatbot bedeutet eine hohe Temperatur dasselbe: Seltene Tokens kommen öfter dran, passende ebenso wie unpassende.
Die drei Scores sind die ausgedachten aus dem Text. Ein Mensch hat sie gesetzt, trainiert wurde nichts. Ein echtes Modell verteilt sein Rad auf Zehntausende bis Hunderttausende Tokens. Die Prozente gelten deshalb nur für dieses Beispiel; zeigen soll die Demo, wie die Temperatur die Felder verändert. Gerechnet wird wie im Text: jeden Score durch die Temperatur teilen, dann Softmax. Gedreht wird mit dem Zufallsgenerator deines Browsers. „< 1 %“ heißt: weniger als ein Prozent. Solche Reste gehören zu den 100 %, ihr Wert steht nicht da.
Halbieren die Abstände, gleichen sich die Felder an. Für „fliegt“ heißt das rund 8 Prozent statt rund 1, bei 100 Drehungen etwa achtmal so oft wie vorher.
Eine Ebene tiefer: Wie rechnet Softmax bei Temperatur 2?
Bei Temperatur 2 wird jeder Score durch 2 geteilt. Dadurch wird jeder Abstand zwischen zwei Scores halb so groß. Aus 3, 2 und −1 werden 1,5, 1 und −0,5. Für „sitzt“ bei 1,5 Punkten ist die Stärke e hoch 1,5. Das ist e · e hoch 0,5, und e hoch 0,5 ist die Wurzel aus e, rund 1,65. Also hat „sitzt“ die Stärke e · 1,65, rund 4,5. Bei einem Punkt hat „schläft“ die Stärke e, also rund 2,7. Bei −0,5 Punkten hat „fliegt“ die Stärke 1 durch 1,65, also rund 0,6. Zusammen rund 7,8. Davon bekommt „sitzt“ rund 57 Prozent, „schläft“ rund 35 und „fliegt“ rund 8.
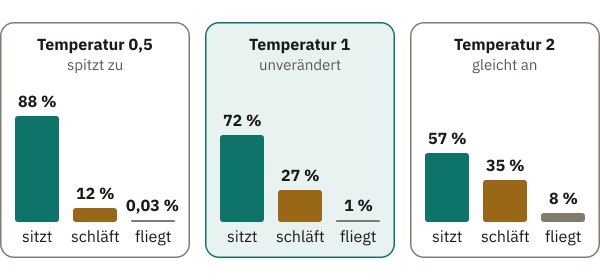
Je näher die Temperatur an null rückt, desto größer werden die Abstände, bis praktisch nur das größte Feld übrig bleibt. Durch null selbst lässt sich nicht teilen, deshalb nehmen viele Programme bei Temperatur null das größte Feld, ohne zu drehen. Das ist die Greedy-Auswahl.
Am Modell ändert die Temperatur nichts: Es gibt dieselben Scores aus. Sie wird nicht trainiert und kann bei jeder Anfrage anders gesetzt werden. Die Temperatur macht das Modell nicht klüger. Ein hoher Wert macht die Antworten abwechslungsreicher: Seltene Tokens bekommen öfter eine Chance, passende ebenso wie unpassende. Ein niedriger Wert macht sie gleichförmiger. Ob eine Chat-App einen Temperatur-Regler anbietet, hängt vom Anbieter ab.
Was 72 Prozent nicht bedeuten
Gibt ein Modell „sitzt“ 72 Prozent, liegt die Annahme nahe, es sei zu 72 Prozent sicher, dass „sitzt“ stimmt. Gemeint ist aber nur die Größe des Felds auf dem Rad für das nächste Token. Woher diese Größe kommt, zeigt das Training: Das Modell lernte aus sehr vielen Texten, welches Textstück im echten Text auf den Anfang folgte. Dieses Textstück heißt Label.
Angenommen, in den Trainingstexten folgt auf „Die Katze“ siebenmal „sitzt“ und dreimal „schläft“. Jedes Beispiel stellt die Parameter ein kleines Stück nach, sodass der Score seines Labels im Vergleich zu den anderen steigt. Je weiter das richtige Stück schon vorn liegt, desto kleiner fällt seine Korrektur aus. „sitzt“ ist öfter das Label, sein Score steigt also öfter.
Im Idealfall nähert sich das Modell an, wie oft eine Fortsetzung nach demselben Anfang folgte: nach „Die Katze“ also sieben von zehn Mal „sitzt“, rund 70 Prozent. Das ist eine andere Größe als die 72 Prozent von oben: Dort rechnete das Modell, hier wird in Texten gezählt. Ob sie stimmt, prüft niemand. Auch das Nachtraining, das den Chatbot hilfreich macht, verschiebt die Scores noch einmal. Auch dann sind die Felder kein verlässliches Maß dafür, ob eine Antwort stimmt.
Angenommen, auf „Die Hauptstadt von Australien ist“ folgt in vielen Trainingstexten „Sydney“. Dann bekommt „Sydney“ ein großes Feld, obwohl Canberra die Hauptstadt ist. Ein Chatbot formuliert eine falsche Antwort dann genauso flüssig wie eine richtige. Wie oft das vorkommt, zeigt ein späterer Baustein über überzeugend falsche Antworten.
Die Scores berechnet das Modell aus seinen Parametern. Anders als die Temperatur werden diese Parameter im Training eingestellt.
Zurück zur Frage vom Anfang: Die andere Antwort beim Neu-Erzeugen kommt, wenn die App mit Sampling arbeitet, aus einer neuen Drehung am selben ersten Rad. Die Parameter des Modells haben sich dabei nicht verändert.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.