Baustein 3 von 5 · Wie Lernen funktioniertGelesen
Backpropagation und Gradienten: Wie das Modell weiß, was es ändern muss
Wie das Training aus einer einzigen Fehlerzahl für jeden Regler Richtung und Stärke ausrechnet, warum dafür ein Rückweg durch das Modell genügt und warum dabei noch kein Regler bewegt wird.
Am Ende des Vorwärtsdurchlaufs, dem Rechnen von der Eingabe durch alle Schichten bis zur Ausgabe, steht eine einzige Zahl für den ganzen Batch, den großen Stapel Text, den das Training auf einmal auswertet: der Loss. Er sagt, wie falsch das Modell bei all diesen Beispielen lag. Er sagt nicht, welcher der Milliarden Regler wie viel dazu beigetragen hat. Im Baustein über Training stand dazu ein Versprechen: Ein Rechenverfahren namens Backpropagation liefere die Steigung für alle Regler zugleich, in einem einzigen Durchgang rückwärts durch das Modell.
Stell dir das Treppenlicht aus dem Baustein über Schichten vor: ein kleines Netz mit zwei Schaltern, bei dem das Licht brennt, wenn genau einer gedrückt ist. Angenommen, du willst durch Probedrehen herausfinden, welcher Regler den Fehler wie stark verändert. Wie viele zusätzliche Vorwärtsdurchläufe durch das Netz bräuchtest du dafür? Halte deine Vermutung fest.
Ein Zettel für jeden Regler
Ein Mischpult klingt schief. Viele Regler, ein schlechter Klang: Welcher muss wohin? Seine Regler sind die Parameter des Modells, also die Gewichte und Grundregler, die das Training einstellt. Sie sind gespeichert und bleiben, wie sie sind, solange niemand an ihnen dreht.
Neu sind die Zettel. Nach jedem Batch rechnet das Training aus dem Loss und den Zwischenwerten des Vorwärtsdurchlaufs an jedem Regler einen Zettel aus, mit zwei Angaben, einer Richtung und einer Stärke: „höher, stark“ auf dem einen, „tiefer, kaum“ auf dem anderen. Anders als die Regler gehören die Zettel nicht zum fertigen Modell. Sie gelten für diesen einen Batch; für den nächsten rechnet das Training neue. Ein Zettel dreht auch keinen Regler, und er sagt nicht, wo der richtige Wert liegt.
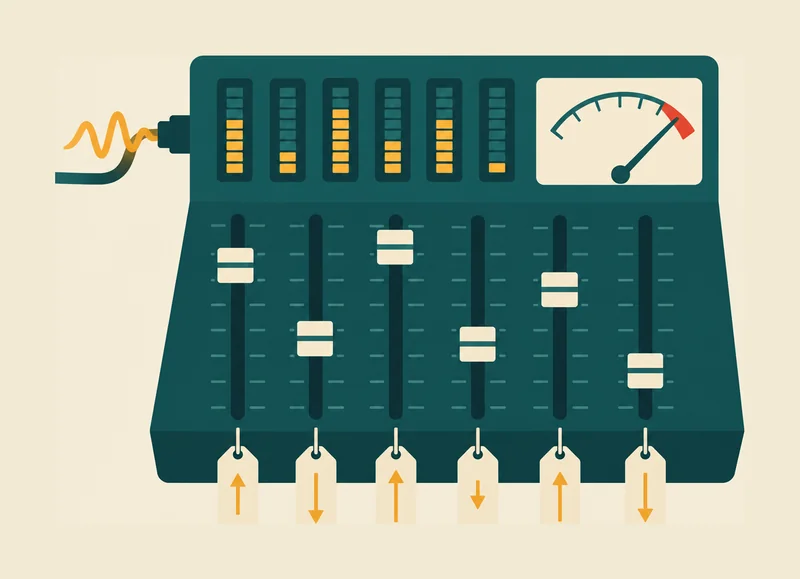
Was auf einem Zettel steht, kennst du ebenfalls: Es ist die Steigung aus dem Baustein über Training. Dort hieß Steigung, wie stark sich der Fehler bei einer winzigen Drehung genau an einer Stelle ändert. Fällt der Fehler beim Höherdrehen, steht auf dem Zettel „höher“. Steigt er, steht dort „tiefer“. Aus dem Apfel-Modell kennst du ein Modell mit nur einem Regler, dem Preis pro Kilo: Dort gab es deshalb nur eine Steigung. Ein Sprachmodell hat Milliarden Regler, und jeder braucht seine eigene. Erinnerst du dich an den Nebel-Hang? Dort spürtest du nur, wohin der Boden unter deinen Füßen abfällt und wie steil. Ein Zettel misst genau das, für einen einzelnen Regler.
Alle Zettel zusammen heißen Gradient: die Liste der Steigungen aller Regler, für jeden Regler Richtung und Stärke. Llama 3.1 8B, das frei veröffentlichte Modell aus dem Baustein über Training, hat laut seiner Modellseite rund acht Milliarden Parameter. Nach jedem Batch bekommt es also rund acht Milliarden Zettel.
Oft gilt Backpropagation als Name für das ganze Lernen. Ein Lehrbuch über neuronale Netze stellt klar: Das Wort bezeichnet nur das Verfahren, das den Gradienten berechnet. Gelernt wird mit einem anderen Verfahren, das diesen Gradienten benutzt. Nach der Backpropagation stehen alle Regler noch wie vorher. Ob und wie weit gedreht wird, entscheidet ein eigener Schritt danach.
Woher aber kommen die Zettel? Am Treppenlicht lässt sich jeder einzelne nachrechnen.
Rückwärts durch das Treppenlicht
Das Treppenlicht ist ein ausgedachtes Mini-Netz: Seine Gewichte setzt ein Mensch, trainiert wurde nichts. Die Neuronen A und B sehen beide Schalter mit dem Gewicht 1 und zählen ihren Grundregler dazu, bei A 0, bei B −1. Die Untergrenze setzt negative Summen auf null. C nimmt A mal 1 und B mal −2. So ergeben sich für die vier Fälle diese Ausgaben:
| Fall | A | B | C |
|---|---|---|---|
| keiner | 0 | 0 | 0 |
| nur oben | 1 | 0 | 1 |
| nur unten | 1 | 0 | 1 |
| beide | 2 | 1 | 0 |
Ein Regler ist von Hand verstellt: Das Gewicht von C für B steht auf −1 statt −2. Falsch wird nur der Fall „beide“, dort zeigt C 1 statt 0. Der Fehler ist die Abweichung mal sich selbst: C liegt 1 zu hoch, der richtige Wert ist 0, also 1 mal 1, gleich 1. Sprachmodelle messen ihren Fehler mit den Strafpunkten aus dem vorigen Baustein, je kleiner die Wahrscheinlichkeit für das richtige Token, desto mehr. Bei ihnen macht der Rückweg dieselbe Rechnung, nur mit der Steigung dieser Strafpunkte. Alle Zettel gelten für diesen einen Fall.
Der Rückweg beginnt an der Ausgabe von C. Sie ist kein Regler, aber an ihr hängt der Fehler. Rückt sie ein kleines Stück, wächst der Fehler etwa doppelt so schnell wie der Schritt. Bei „Abweichung mal sich selbst“ ist diese Steigung an C immer das Doppelte der Abweichung. Für einen Regler heißt positiv „tiefer“, denn höher gedreht würde der Fehler wachsen; negativ „höher“.
Eine Ebene tiefer: Wie viel wächst der Fehler bei einem kleinen Schritt?
Der Fehler ist hier C mal C, weil der richtige Wert 0 ist. Rückt C um 0,01 auf 1,01, wird er 1,01 mal 1,01, gleich 1,0201, also rund 0,02 größer als vorher. Geteilt durch den Schritt 0,01 ergibt das rund 2: die Steigung an C an dieser Stelle. Bei einer Abweichung von 0,5 wäre sie rund 1, also wieder das Doppelte.
Die Gegenprobe am verstellten Regler: Dreht man das Gewicht von C für B von −1 auf −1,01, rechnet C im Fall „beide“ 2 minus 1,01, also 0,99. Der Fehler sinkt dann auf 0,99 mal 0,99, rund 0,98. Das ist ein Rückgang um rund 0,02 bei einem Schritt von 0,01, also Steigung rund 2, wie der Zettel sagt.
Dreht sich das Gewicht von C für B ein Stück, ändert sich C um dieses Stück mal die Ausgabe von B, einen Zwischenwert vom Vorwärtsdurchlauf. Der Zettel ist die Steigung an C mal diese Ausgabe, also 2. Das Gewicht von C für A bekommt 2 mal 2, also 4, der Grundregler von C 2: alle drei „tiefer“.
Was steht auf dem Zettel des Gewichts von B am oberen Schalter: höher oder tiefer? Überleg, bevor du weiterliest.
Live-Demo · zum Ausprobieren
Der Rückweg durch das Treppenlicht
Ausgedachte SimulationZielfrage: Was steht im Fall „beide“ auf dem Zettel am Gewicht von B für den oberen Schalter, höher oder tiefer? Vermute zuerst, dann geh den Rückweg Schritt für Schritt.
Wähle zuerst deine Vermutung. Dann geht der Rückweg los.
| Regler | Stellung | Zettel |
|---|---|---|
| A: Gewicht oben | ||
| A: Gewicht unten | ||
| A: Grundregler | ||
| B: Gewicht oben | ||
| B: Gewicht unten | ||
| B: Grundregler | ||
| C: Gewicht für A | ||
| C: Gewicht für B | ||
| C: Grundregler |
Andere Fälle und der Batch
Auflösung
Der Zettel sagt −2, also höher. Warum: Die Steigung an C ist 2, das Gewicht von C für B steht auf −1, der Einfluss von B ist also 2 · (−1) = −2. Die Untergrenze lässt durch und zählt als 1, der gedrückte Schalter ebenfalls. Ein höheres B senkt C von 1 Richtung 0, der Fehler wird kleiner. Der größte Zettel, die 4, hängt am Gewicht von C für A, das richtig steht; der verstellte Regler, das Gewicht von C für B, bekommt nur 2, aber in die richtige Richtung, tiefer. Unter „Andere Fälle“ siehst du außerdem, dass die Untergrenze im Fall „keiner“ sperrt und dass sich die Fälle widersprechen, sobald das Gewicht von C für A auf 0,9 rückt.
Alle Zahlen sind ausgedacht, ein Gewicht ist von Hand verstellt: C nimmt B mal −1 statt mal −2. Die Demo zeigt nur, wie die Zettel entstehen. Wie gut ein echtes Modell lernt, lässt sich daraus nicht ablesen.
Für die Regler von B rechnet der Rückweg erst den Einfluss von B: wie stark der Fehler auf B reagiert. B wirkt über das Gewicht von C für B auf C, also zählt die Steigung an C mal dieses Gewicht: 2 mal −1, gleich −2. Die Untergrenze lässt die positive Summe von B durch. Liegt eine Summe unter null, macht die Untergrenze daraus 0, und die Regler dieses Neurons bekommen keinen Zettel. Das Gewicht am oberen Schalter bekommt −2 mal den gedrückten Schalter: Zettel −2, höher.
Ein Gegenfall zeigt die Sperre: Stünde der Grundregler von C auf 0,5, zeigte C im Fall „keiner“ 0,5. Dort ist die Summe von B −1; die Untergrenze macht daraus 0, und die Regler von B bekommen in diesem Fall keinen Zettel.
| Regler | Rechnung (vorne die Steigung an C) | Zettel |
|---|---|---|
| C: Gewicht für A | 2 · Ausgabe von A (2) | 4, tiefer |
| C: Gewicht für B | 2 · Ausgabe von B (1) | 2, tiefer |
| C: Grundregler | 2 · 1 | 2, tiefer |
| B: beide Gewichte, Grundregler | 2 · Gewicht von C für B (−1) · Untergrenze (1) · Eingabe (1: gedrückter Schalter, beim Grundregler 1) | je −2, höher |
| A: beide Gewichte, Grundregler | 2 · Gewicht von C für A (1) · Untergrenze (1) · Eingabe (1: gedrückter Schalter, beim Grundregler 1) | je 2, tiefer |
Der größte Zettel, die 4, hängt am Gewicht von C für A, das richtig steht. Der verstellte Regler, das Gewicht von C für B, bekommt 2, aber in die richtige Richtung, tiefer. Ein Zettel misst, wie stark der Fehler an einem Regler hängt, nicht, wer ihn verursacht hat.
Ein Rückweg statt Milliarden Proben
Dieser Rückweg heißt Backpropagation, ungefähr „Rückwärtsausbreitung“: Vom Fehler aus geht die Rechnung Schicht für Schicht zurück zum Eingang, und jeder Regler bekommt unterwegs seinen Zettel. Wer stattdessen probedreht, wie in der Frage vom Anfang, dreht einen Regler ein Stück, rechnet das Netz vorwärts und vergleicht den neuen Fehler mit dem alten.
Live-Demo · zum Ausprobieren
Probedrehen oder ein Rückweg
Ausgedachte SimulationZielfrage: Wie viele zusätzliche Vorwärtsdurchläufe braucht das Probedrehen im Treppenlicht, bis klar ist, welcher Regler den Fehler wie stark verändert? Vermute zuerst, dann probier es aus.
Wähle zuerst deine Vermutung. Dann geht das Probedrehen los.
| Regler | Probedrehen | Rückweg |
|---|---|---|
| A: Gewicht oben | … | … |
| A: Gewicht unten | … | … |
| A: Grundregler | … | … |
| B: Gewicht oben | … | … |
| B: Gewicht unten | … | … |
| B: Grundregler | … | … |
| C: Gewicht für A | … | … |
| C: Gewicht für B | … | … |
| C: Grundregler | … | … |
Auflösung
Es sind neun: ein zusätzlicher Vorwärtsdurchlauf pro Regler. Alle auf einmal zu drehen verriete nicht, welcher Regler wie viel beiträgt. Jede Probe dreht einen Regler um 0,01 und vergleicht den neuen Fehler mit dem alten. Das ergibt Zettel wie 2,01 oder 4,04, also nur ungefähr. Der Rückweg liefert dieselben Zettel genau, mit einem einzigen Durchgang, weil er den Einfluss jedes Neurons nur einmal berechnet und für alle seine Regler nutzt. Bei Llama 3.1 8B wären es für jedes Beispiel rund acht Milliarden Proben, der Rückweg kostet dagegen etwa so viel wie zwei Vorwärtsdurchläufe.
Alle Zahlen des Treppenlichts sind ausgedacht, ein Gewicht ist von Hand verstellt, gerechnet wird im Fall „beide“. Echt ist nur die Zahl der Parameter von Llama 3.1 8B, laut seiner Modellseite.
Beim Treppenlicht sind das neun zusätzliche Vorwärtsdurchläufe, einer pro Regler: Alle auf einmal zu drehen verriete nicht, welcher Regler wie viel beiträgt. Die Backpropagation brauchte einen einzigen Rückweg.
Warum reicht einer? Der Einfluss von B, die −2, wurde einmal berechnet und für alle drei Regler von B benutzt. Läge vor B noch eine Schicht, würde der Rückweg aus dem Einfluss von B den Einfluss dieser Schicht berechnen, wieder nur einmal, und so weiter bis zum Eingang.
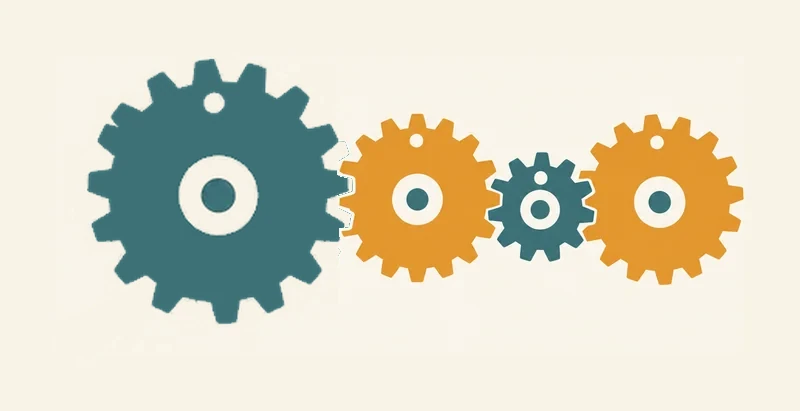
Die Rechnung funktioniert wie ein Getriebe: Wie stark das letzte Zahnrad mitgeht, ergibt das Produkt der Übersetzungen auf dem Weg. Für das Gewicht von B am oberen Schalter sind es die vier Faktoren aus der Tabelle. Malgenommen ergibt das −2, den Zettel. Für alle drei Regler von B sind die ersten drei Faktoren gleich; nur der letzte, die Eingabe des jeweiligen Reglers, kann wechseln. Anders als im echten Getriebe bleiben hier die Gewichte stehen; die Untergrenze und die Eingabe des jeweiligen Reglers übersetzen mal mit 1, mal mit 0.
Fließt da der Fehler rückwärts und repariert die Regler? Nein, rückwärts läuft eine Rechnung mit den Werten vom Vorwärtsdurchlauf: Ohne die 2 von A und die 1 von B ließe sich kein Zettel an C ausrechnen. Deshalb hebt das Training sie auf, bis der Rückweg fertig ist.
Umsonst ist der Rückweg nicht. Vorwärts rechnet jedes Gewicht einmal: Gewicht mal Eingabe. Rückwärts rechnet es zweimal. Erstens: Einfluss mal Eingabe ergibt seinen eigenen Zettel. Zweitens: Einfluss mal Gewicht ergibt den Einfluss, den es an die Schicht davor weitergibt. Ein Papier von OpenAI, der Firma hinter ChatGPT, fasst das 2020 in eine Faustregel: Der Rückweg kostet etwa doppelt so viel Rechenarbeit wie der Vorwärtsdurchlauf, zusammen etwa dreimal so viel wie das reine Antworten. Für Llama 3.1 8B kostet ein Trainingsschritt pro Token etwa so viel wie drei Vorwärtsdurchläufe.
Eine Ebene tiefer: Warum können Zettel verschwinden oder riesig werden?
In der Mathematik heißt das Malnehmen der Übersetzungen Kettenregel der Differentialrechnung. Paul Werbos beschrieb die Rückwärtsrechnung allgemein 1974 in seiner Dissertation; für neuronale Netze legte er sie 1981 auf einer Konferenz dar, veröffentlicht 1982. 1986 machten David Rumelhart, Geoffrey Hinton und Ronald Williams ihn in der Fachzeitschrift Nature bekannt; andere hatten ihn etwa zur selben Zeit unabhängig wiederentdeckt.
Liegen viele Übersetzungen unter 1, schrumpft das Produkt mit jeder Schicht: Zehnmal 0,5 malgenommen ergibt weniger als ein Tausendstel. Die Zettel nahe am Eingang werden dann so klein, dass die Richtung kaum noch zu erkennen ist. Liegen viele Übersetzungen über 1, wächst das Produkt rasch, die Zettel werden riesig, und das Lernen kann unruhig werden. Das Lehrbuch über neuronale Netze nennt das das Problem der verschwindenden und explodierenden Gradienten.
Treffen kann das jedes sehr tiefe Netz, am stärksten aber Netze, die bei jedem Schritt dieselben Gewichte anwenden: Dieselbe Übersetzung kehrt wieder, und schon eine knapp unter 1 schrumpft mit jeder Wiederholung. In Netzen, in denen Werte nur von Schicht zu Schicht nach vorn laufen (Feed-Forward), hat jede Schicht eigene Gewichte, und laut dem Lehrbuch können auch sehr tiefe Netze dieser Art das Problem weitgehend vermeiden. Gegen riesige Zettel hilft eine Grenze. Beim Training von GPT-3 wurde die Gesamtgröße des Gradienten auf 1,0 begrenzt: War sie größer, wurden alle Zettel im gleichen Verhältnis verkleinert; ihre Richtungen blieben.
Ein Zettel gilt nur hier und jetzt
Im Fall „beide“ sagt der Zettel am Gewicht von C für A „tiefer, 4“, so deutlich wie kein anderer. Was passiert, wenn das Gewicht ihm weit folgt, von eins bis auf null? Überleg kurz, bevor du weiterliest.
Im Fall „beide“ rechnet C dann null mal zwei, dazu minus eins mal eins. Das ergibt minus eins: wieder falsch, nur in die andere Richtung. Und die Fälle „nur oben“ und „nur unten“, die vorher stimmten, gehen kaputt: A rechnet eins, B rechnet null, und C zeigt null statt eins. Das Licht bliebe bei genau einem gedrückten Schalter dunkel.
Leicht entsteht der Eindruck, ein Zettel zeige auf den richtigen Wert. Er zeigt aber nur die Neigung an der jetzigen Stelle, wie im Nebel. Wer weit ausschreitet, kann wieder bergauf landen. Deshalb gilt ein Zettel nur für die Stellung, an der er ausgerechnet wurde.
Er gilt außerdem nur für den Fall, aus dem er stammt. Im verstellten Netz stimmen die anderen drei Fälle, ihr Zettel ist null. Andere Beispiele geben andere Zettel, und die können einander widersprechen. Rückt nur das Gewicht von C für A auf 0,9, verlangt der Fall „nur oben“ ein Hochdrehen, also „höher“, der Fall „beide“ ein Herunterdrehen, also „tiefer“. Die Zettel widersprechen sich.
Eine Ebene tiefer: Wie kommen die Zettel −0,2 und 3,2 zustande?
Die Rechnung ist immer dieselbe: Steigung an C mal Ausgabe von A. Im Fall „nur oben“ steht das Gewicht auf 0,9: C rechnet 0,9 mal 1 und zeigt 0,9 statt 1, liegt also 0,1 zu tief. Die Steigung an C ist dann 2 mal (−0,1), gleich −0,2. Mal die Ausgabe von A, 1, ergibt der Zettel −0,2, also „höher“. Im Fall „nur unten“ ist es genauso.
Im Fall „beide“ rechnet C 0,9 mal 2 minus 1, also 0,8. Es liegt 0,8 zu hoch, die Steigung ist 2 mal 0,8, gleich 1,6. Mal die Ausgabe von A, 2, ergibt der Zettel 3,2, also „tiefer“. Dass die Steigung hier positiv ist und dort negativ, folgt aus der Lage von C: zu tief heißt „höher“, zu hoch heißt „tiefer“.
Deshalb rechnet das Training die Zettel aller Beispiele eines Batch aus und mittelt sie. Der Loss eines Batch ist der Durchschnitt über seine Beispiele, und jedes Beispiel geht nur mit seinem Anteil in diesen Durchschnitt ein, samt seiner Steigung. Deshalb ist jeder Zettel ein Durchschnitt. Für das Gewicht von C für A ergibt die Summe der vier Zettel 2,8, durch vier geteilt 0,7: tiefer, aber viel schwächer als die 3,2 aus dem Fall „beide“ allein. Beim Training von GPT-3, einem frühen Sprachmodell von OpenAI, wuchs ein Batch im Lauf des Trainings auf Millionen Tokens. Jedes Token ist ein solches Beispiel und trägt seine Zettel zum Durchschnitt bei. Dann dreht das Training die Regler ein Stück in die Richtung ihrer Zettel, und der nächste Batch bringt neue Zettel.
Bis hierhin hat sich kein Regler bewegt. Wie weit gedreht wird und was mit widersprüchlichen Zetteln geschieht, klärt der nächste Baustein über die Optimierung der Gewichte.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.