Baustein 4 von 9 · GrundlagenGelesen
Token-IDs: Was eine Nummer bedeutet
Zeigt, was eine Token-ID ist: eine Nummer, die nur im Vokabular ihres Tokenizers gilt. Außerdem erklärt der Baustein, warum jedes Modell genau zu dem Tokenizer passt, mit dem es trainiert wurde, und warum die Nummer selbst nichts über das Stück verrät.
Ein Sprachmodell rechnet nur mit Zahlen, nie mit Text. Also bekommt jedes Stück eine Nummer, etwa das Stück „Frank“ aus „Frankreich“.
Jedes Stück bekommt eine Nummer
Jedes Stück im Vokabular hat eine feste Nummer, seine Token-ID. Der Tokenizer legt sie einmal fest, wenn er sein Vokabular lernt. Danach ändert sie sich nie. Die Nummer zeigt nur, an welcher Stelle im Vokabular ein Stück steht.
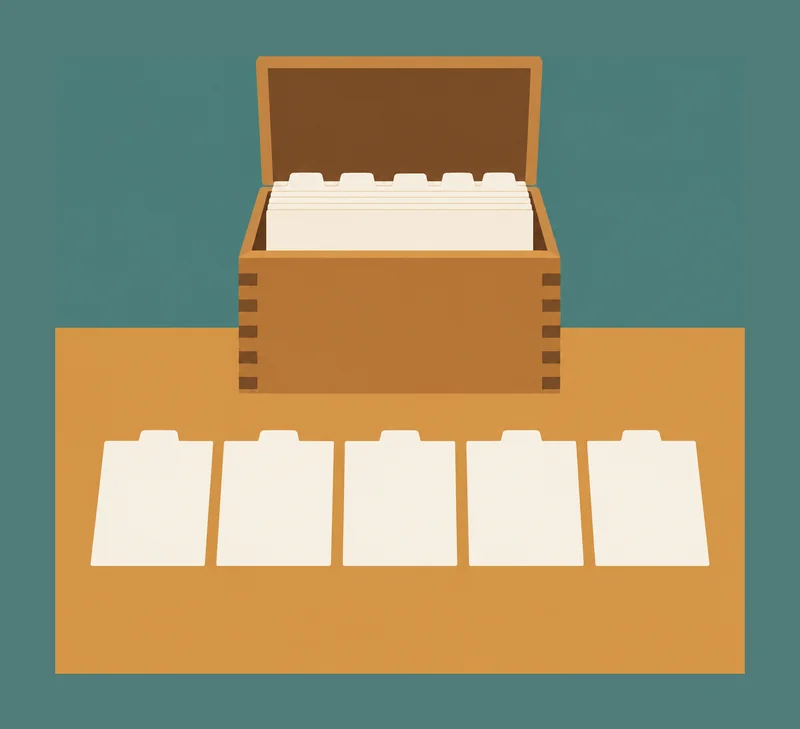
Das Vokabular ist der Kasten aus dem vorigen Baustein. Auf jedem Stück darin steht eine Nummer. Zu jedem Stück in deinem Text wird genau dieses Stück herausgesucht, und seine Nummer wird übernommen. Der Tokenizer wählt dabei nichts aus, er folgt seinen Regeln. Am Ende steht eine Reihe von Nummern da, in derselben Reihenfolge wie die Stücke. Diese Reihe entsteht für jeden Text neu, ganz gleich wie lang er ist. Auf einem Stück steht nur eine Zeichenfolge, keine Erklärung. Wer den Kasten durchsieht, erfährt nichts über den Sinn eines Stücks.
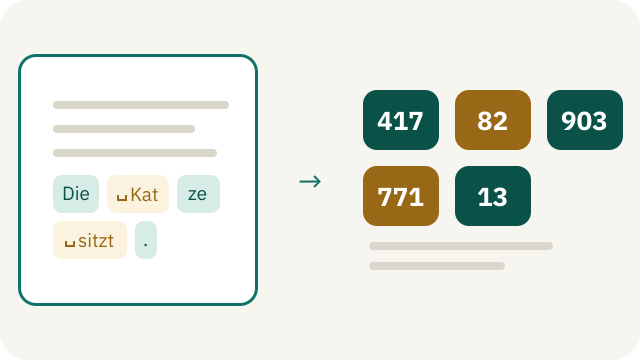
Nimm als Beispiel den Satz „Die Katze sitzt.“ Das Zeichen ␣ steht für ein Leerzeichen, das zum jeweiligen Stück gehört. Der Tokenizer hat den Satz bereits in die Stücke „Die“, „␣Kat“, „ze“, „␣sitzt“ und „.“ zerlegt. Ein Stück „␣Katze“ gibt es im Vokabular nicht, deshalb sind es zwei.
Wie viele Nummern bekommt der Satz? Rate, bevor du weiterliest.
Fünf, eine für jedes Stück. Welche Nummer auf welcher Karte steht, zeigt diese Tabelle:
| Token-ID | Textstück |
|---|---|
| 417 | „Die“ |
| 82 | „␣Kat“ |
| 903 | „ze“ |
| 771 | „␣sitzt“ |
| 13 | „.“ |
Die Stücke und Nummern in diesem Beispiel sind ausgedacht. Sie stammen nicht aus einem Training. Die fünf Karten im Bild zeigen nur einen Ausschnitt aus einem viel größeren Kasten. Deshalb sind sie nicht von 1 bis 5 nummeriert. Das echte Vokabular von GPT-2, einem älteren Sprachmodell von OpenAI, hat 50.257 Einträge, und unter 417 steht dort ein anderes Stück.
Aus dem Satz wird also eine Reihe von fünf Nummern, in derselben Reihenfolge wie die Stücke. Diesen Weg vom Text zu den Nummern nennt man Kodieren. Die fünf Zahlen gehen anschließend als Input ins Modell. Auch deine Nachrichten an einen Chatbot werden auf diese Weise in Nummern umgesetzt, bevor das Modell sie sieht.
Der Rückweg: aus Nummern wird Text
Auch eine Chatbot-Antwort entsteht zunächst als Folge von Nummern. Für jedes Stück im Vokabular gibt das Modell einen Score aus. Dieser bewertet, wie gut das Stück als Nächstes passt. Der Auswahlschritt wählt anhand dieser Werte ein Textstück aus und hängt es an den Text an. Die Score-Liste ist nach den Nummern des Vokabulars geordnet: Eintrag 417 gehört zum Stück „Die“. Wählt der Auswahlschritt Eintrag 82, ist damit „␣Kat“ ausgewählt.
Damit du die Antwort lesen kannst, geht der Tokenizer den umgekehrten Weg. Er schlägt jede Nummer nach und hängt die gespeicherten Stücke in derselben Reihenfolge aneinander. Diesen Rückweg nennt man Dekodieren.
Aus den fünf Nummern der Tabelle wird so wieder „Die Katze sitzt.“. Die Leerzeichen gehen dabei nicht verloren, weil sie schon in „␣Kat“ und „␣sitzt“ gespeichert sind. Auch die Reihenfolge zählt: 82, 903, 417 ergibt „KatzeDie“, mit einem Leerzeichen am Anfang.
Bevor du weiterliest: Was kommt heraus, wenn 417 und 82 die Plätze tauschen?
Gib im Werkzeug einen eigenen Satz ein und vertausche die Nummern. Schalte danach auf „Zeichen“ um: Welche Nummer bekommt „D“ jetzt?
Live-Demo · zum Ausprobieren
Dein Satz, drei Tokenizer
Ausgedachte SimulationWelche Nummer bekommt jedes Token deines Satzes? Rate zuerst; danach zeigt dir die Demo die Nummern. Nach dem ersten Tausch schaltest du zwischen drei erfundenen Tokenizern um.
Rückweg: aus IDs wird wieder Text
Wähle zwei IDs, um sie zu tauschen. Der Tokenizer schlägt jede ID nach und fügt die Stücke in dieser Reihenfolge zusammen.
Auflösung
Der Wortstück-Tokenizer macht aus „Die Katze sitzt.“ fünf Tokens mit den IDs 417, 82, 903, 771 und 13, wie im Text. Tauschst du 417 und 82, kommt „ KatDieze sitzt.“ heraus: Jede Nummer holt nur ihr eigenes Stück zurück, samt Leerzeichen. Im Modus „Zeichen“ bekommt derselbe Satz ganz andere Nummern: Das große „D“ von „Die“ bekommt dort die 68, die Nummer, unter der dieses Zeichen in der internationalen Zeichentabelle steht. Deshalb braucht ein Modell genau den Tokenizer, mit dem es trainiert wurde.
Alle Vokabulare und IDs sind ausgedacht und winzig. Nur im Modus „Zeichen“ sind die IDs echt: Es sind die Nummern der Zeichen in der internationalen Zeichentabelle. Im Modus „Wortstücke“ bekommen Zeichen, die kein Stück des Vokabulars abdeckt, erfundene Nummern ab 5000. Ein echter Tokenizer kennt Zehntausende Stücke und vergibt eigene Nummern, die nur in seinem Vokabular gelten.
Tauschst du sie, kommt „KatDieze sitzt.“ heraus, mit einem Leerzeichen am Anfang. Jede Nummer holt nur ihr eigenes Stück zurück, samt Leerzeichen.
Eine ID ist ein Etikett
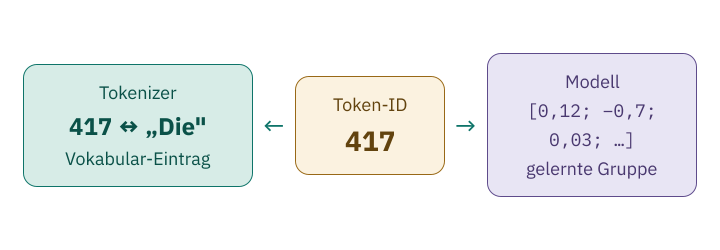
Verrät die Zahl 417 dem Modell, dass „Die“ ein Artikel ist? Nein. Im Mini-Vokabular steht unter 417 „Die“. Im echten GPT-2-Vokabular steht dort dagegen „el“, ein Wortteil. Eine Nummer gilt nur in ihrem Vokabular. Die Zahl selbst trägt für das Modell keine Bedeutung. Auch ihre Größe spielt keine Rolle; das Modell nutzt sie nur zum Nachschlagen.
Wo steckt dann das Wissen über „Die“? Beim Spamfilter aus dem ersten Baustein gab es für jedes Wort eine Zahl, ein Gewicht. Ein Sprachmodell speichert zu jeder Token-ID eine eigene Gruppe gelernter Zahlen. Im ausgedachten Beispiel stehen darin einige Zahlen, die das Training eingestellt hat. Auch das sind Parameter, die im Training eingestellt werden. Die ID sagt nur, welche Gruppe gemeint ist. Mit dieser Gruppe beginnt die Rechnung für das Stück.
Warum Tokenizer und Modell ein festes Paar sind
Kann man einem fertigen Modell einen anderen Tokenizer geben? Stell dir zwei Tokenizer mit gleich vielen Karten vor, die ihre Nummern unterschiedlich verteilen: Beim ersten steht unter 417 „Die“, beim zweiten „el“, wie bei GPT-2. Das Modell wurde mit dem ersten trainiert, erhält nun aber Nummern vom zweiten. Kommt im Text das Stück „el“ vor, liefert der fremde Tokenizer dafür 417. Was macht das Modell daraus? Überlege kurz, bevor du weiterliest.
Es holt die Gruppe, die es für 417 gelernt hat, also für „Die“. Eine Fehlermeldung gibt es hier nicht, denn 417 steht im Vokabular dieses Modells.
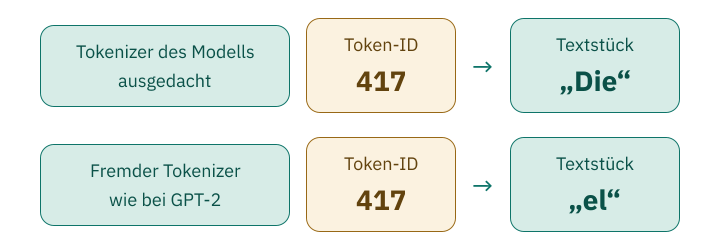
Deshalb gehört zu jedem Modell genau der Tokenizer, mit dem es trainiert wurde, einschließlich seiner Regeln und seines Vokabulars. Seine Parameter hat das Modell für genau eine Zuordnung von Nummern zu Stücken gelernt. Bei einer anderen Zuordnung passen die Nummern nicht mehr zu den gelernten Gruppen. Wechselst du in einer Chat-App zu einem Modell mit anderem Tokenizer, wird deine Nachricht dort anders zerlegt und nummeriert. Oft besteht sie dann auch aus einer anderen Zahl von Tokens. Mehrere Modelle können denselben Tokenizer nutzen; sie teilen dann die Nummern, aber nicht die gelernten Zahlen.
Im Werkzeug oben bekam derselbe Satz bei jedem der drei Tokenizer andere Nummern.
Die Nummern sind erst der Anfang
Wie diese Zahlengruppen aussehen und wie sie zusammen eine Tabelle bilden, zeigt der nächste Baustein: Skalar, Vektor, Matrix, Tensor.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.