Baustein 8 von 9 · Vom Modell zum AssistentenGelesen
Trainingsdaten: Urheberrecht und Datenschutz
Wessen Texte in ein Training dürfen, wie ein Vorbehalt wirkt, warum die erste Frage bei der Kopie liegt und was im Modell bleiben kann. Stand 12.10.2026, keine Rechtsberatung.
Angenommen, du schreibst seit zehn Jahren einen Blog über Gartenarbeit. Eines Tages fragt jemand einen Chatbot nach Tomatenpflanzen, und die Antwort enthält einen Satz, den du fast so geschrieben hast. Ist das erlaubt? Dein Text könnte dabei im Training gelandet sein, ohne dass du davon weißt.
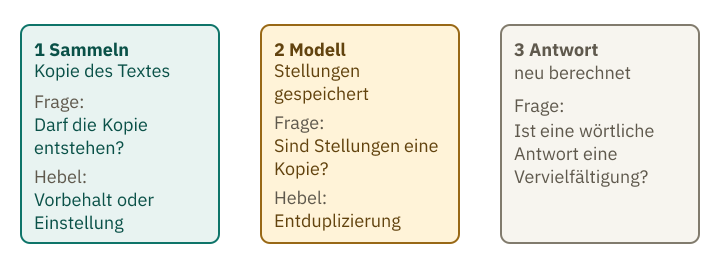
Rechtlich stellen sich dabei drei Fragen: zum Sammeln, bei dem eine Kopie des Textes entsteht; zum Modell, das die Stellungen seiner Regler speichert; und zur Antwort, die bei jeder Frage neu entsteht. An manchen dieser Stellen lässt sich etwas beeinflussen, etwa durch einen Vorbehalt oder eine Einstellung. Solche Möglichkeiten heißen hier Hebel.
Erst die Abschrift, dann das Training
Woher der Rohstoff kommt, hast du im Baustein über Übungsaufgaben gesehen. Ein Sammelprogramm lädt Webseiten herunter. Das ist der erste Schritt, und er kommt vor allen Filtern: Die Seite wird kopiert, bevor daraus etwas gemacht wird. Danach sortieren Regeln aus, was fürs Training taugt, und erst dann beginnt das Training. Die Lösung, das nächste Textstück, steht schon im Text; das erklärt der Baustein über selbstüberwachtes Lernen. Die Kopie kommt aber davor.
Das Urheberrecht schützt einen Text als Werk, wenn ihn ein Mensch geschrieben hat und er eine persönliche geistige Schöpfung ist (§ 2 Abs. 2 UrhG). Nicht jeder Text erfüllt diese Voraussetzung. Ist er geschützt, darf sein Urheber grundsätzlich über Kopien entscheiden. Auch ein Text, der nur einmal von Hand abgeschrieben wurde, ist eine Kopie. Daran ändert sich nichts, wenn ein Programm das Abschreiben in Sekunden erledigt. Die gesammelten Kopien bilden den Datensatz, aus dem später trainiert wird.
Die Regel hat Ausnahmen. Für Text und Data Mining erlaubt § 44b des Urheberrechtsgesetzes (UrhG) das Kopieren, in der Fachsprache Vervielfältigungen. Text und Data Mining ist die automatisierte Analyse digitaler Werke, um Muster, Trends und Zusammenhänge zu finden. Die Ausnahme gilt nur für Werke, die rechtmäßig zugänglich sind. Sie ist damit eine enge Erlaubnis für eine bestimmte Auswertung, kein allgemeiner Freibrief für jede Nutzung eines Textes. Das Bild zeigt nur den ersten Schritt, das Sammeln. Ob das Modell danach etwas Ähnliches enthält, kommt in den Abschnitten unten.
Rechtmäßig zugänglich heißt: Der Text ist auf einem rechtlich erlaubten Weg verfügbar, etwa weil der Autor ihn selbst veröffentlicht hat. Dass ein Text öffentlich im Netz steht, reicht dafür allein nicht aus. Ein Gedicht, das der Autor nur im Familienkreis per Brief geteilt hat, ist nicht öffentlich zugänglich. Ein Sammelprogramm erreicht es nicht; die Ausnahme kommt hier gar nicht erst zum Tragen. Ob sie bei einem öffentlichen Blog greift, hängt davon ab, ob der Betreiber einen Vorbehalt gesetzt hat. Das ist der nächste Abschnitt.
Ein Webarchiv sammelt zum Beispiel fünf Seiten zum selben Thema. Beim Aussortieren fallen vier heraus, weil sie zu kurz oder doppelt sind; nur eine Anleitung bleibt. Zu diesem Zeitpunkt sind aber schon alle fünf Seiten kopiert. Deshalb muss zuerst geklärt werden, ob diese Kopien erlaubt waren.
Bevor du die Einstellungen in der Demo änderst: Bei welcher der drei Stellen bleibt die rechtliche Frage offen, wenn der Vorbehalt fehlt, der Text öffentlich ist und oft wiederholt wurde? Wähle diese Einstellungen und prüfe deine Vermutung.
Live-Demo · zum Ausprobieren
Drei Stellen für einen Text
Ausgedachte SimulationStell einen Text ein, dann siehst du, welche Frage an jeder der drei Stellen steht: beim Sammeln, im Modell und in der Antwort.
Weitere Angaben
- 1 Sammeln
- 2 Modell
- 3 Antwort
- Datenschutz
Auflösung
Offen bleibt das Modell. Ohne Vorbehalt kann die Ausnahme beim Sammeln eines öffentlichen Blogs greifen; wiederholte Fundstellen machen eine wörtliche Passage wahrscheinlicher; ob die Stellungen als Kopie gelten, hat noch kein Gericht abschließend entschieden. Regel je Zeile: Vorbehalt wirkt auf das Sammeln, Wiederholung auf das Modell, Antwort auf die Wiedergabe.
Alle Angaben sind vereinfacht und ausgedacht. Die Demo zeigt, welche Frage an welcher Stelle steht, nicht, wie ein Gericht entscheidet. Keine Rechtsberatung und keine Zahlen.
Ein Vorbehalt, den nur ein Computer lesen kann
Was, wenn der Betreiber nicht will, dass sein Blog gesammelt wird? Dafür gibt es den Nutzungsvorbehalt. Das ist die Erklärung des Rechteinhabers, dass er eine bestimmte Nutzung nicht erlaubt. Das Gesetz verlangt dafür eine bestimmte Form. Der Wortlaut in § 44b Abs. 3 UrhG lautet: „Ein Nutzungsvorbehalt bei online zugänglichen Werken ist nur dann wirksam, wenn er in maschinenlesbarer Form erfolgt.“
Maschinenlesbar heißt: in einer standardisierten Form, die ein Programm finden und auswerten kann. Ein Satz im Impressum wie „Keine Nutzung für KI-Training“ ist für Menschen klar, aber er steht nicht in dieser Form. Nach dem Wortlaut genügt er deshalb nicht.
Ein Beispiel für eine maschinenlesbare Angabe ist die robots.txt, eine Textdatei auf der Website mit Anweisungen für Crawler. Common Crawl, eine Organisation, die Webseiten sammelt und ihr Archiv frei zur Verfügung stellt, beschreibt dafür die Zeile „User-agent: CCBot“ mit „Disallow: /“. Ob eine robots.txt rechtlich als Vorbehalt im Sinne des Gesetzes gilt, ist nicht geklärt.
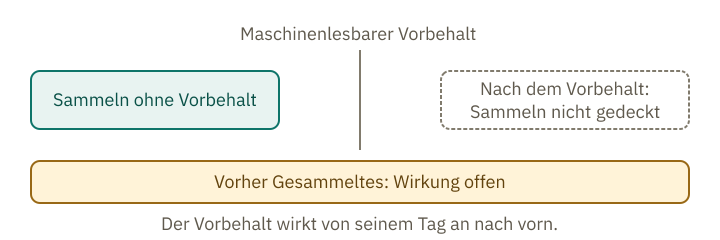
Der Vorbehalt betrifft künftige Nutzungen. Deshalb kommt es darauf an, wann er gesetzt wird. Der Wortlaut erfasst bereits gesammelte Texte nicht ausdrücklich. Wie eine vorhandene Kopie nach dem Vorbehalt zu behandeln ist, bleibt offen. Für den Verbleib der Kopien gibt § 44b Abs. 2 Satz 2 UrhG einen Maßstab: Vervielfältigungen sind zu löschen, wenn sie für das Text und Data Mining nicht mehr erforderlich sind. Ob das Training selbst ein solches Text und Data Mining ist, ist offen. Für einen gesetzlichen Vorbehalt gibt es dazu keine abschließende Antwort.
Was passiert, wenn der Vorbehalt erst nach dem Sammeln kommt?
Dann ist die Kopie bereits entstanden. Der Vorbehalt betrifft künftige Nutzungen. Ob er auch eine vorhandene Kopie erfasst, bleibt offen, wie im Abschnitt davor beschrieben. Davon unabhängig gilt die Löschpflicht nach § 44b Abs. 2 Satz 2 UrhG; sie betrifft nur Kopien, die nicht mehr gebraucht werden. Eine abschließende Antwort der Gerichte auf die offene Frage steht noch aus.
Wenn im Text Menschen vorkommen
In Texten im Netz stehen oft auch Angaben über Menschen: Namen, Telefonnummern und E-Mail-Adressen findest du etwa in Foren, Impressen und Kommentaren. Das sind personenbezogene Daten, also Angaben, die eine bestimmte Person erkennbar machen. Für sie gilt die Datenschutz-Grundverordnung (DSGVO), sobald sie verarbeitet werden, also schon beim Sammeln. Beim Urheberrecht geht es um die Kopie, beim Datenschutz um die Angaben über Menschen. Beide können beim selben Text eine Rolle spielen.
Eine Verarbeitung braucht eine Rechtsgrundlage. Art. 6 Abs. 1 lit. f DSGVO nennt die Abwägung: Die Verarbeitung ist erlaubt, wenn ein berechtigtes Interesse besteht und nicht die Interessen oder Grundrechte der betroffenen Person überwiegen. Wer abwägt, muss das für den Einzelfall tun. Ein pauschales Ergebnis gibt es nicht.
Bist du betroffen, kannst du nach Art. 21 Abs. 1 DSGVO aus Gründen deiner besonderen Situation gegen eine solche Verarbeitung Widerspruch einlegen. Dafür brauchst du also Gründe, die mit deiner persönlichen Situation zusammenhängen; der Wunsch allein reicht nicht.
Dass solche Angaben aus einem Modell herausgeholt werden können, zeigt eine Untersuchung. Carlini und andere gewannen mit gezielten Abfragen Texte mit Namen, Telefonnummern und E-Mail-Adressen aus einem Sprachmodell. Das ist ein Befund über die Ausgabe bei gezielter Suche, nicht über das, was das Modell speichert. Und es ging um ein älteres Modell.
Bei großen Plattformen zeigt sich der Hebel des Widerspruchs. Nach Angaben der Verbraucherzentrale nutzt Meta, der Konzern hinter Facebook und Instagram, seit dem 27. Mai 2025 öffentliche Inhalte von Erwachsenen in der EU für KI-Training. Ein Widerspruch ist möglich und wirkt nach dieser Auskunft für die Zukunft.
Ob ein trainiertes Modell selbst noch personenbezogene Angaben enthält, ist eine offene Frage.
Was im Modell bleibt
Das Modell speichert keine Textdatei. Erinnerst du dich an das Mischpult aus dem Baustein über das Modell? Gespeichert sind die Stellungen der Regler, keine Sätze. Der Vergleich hat allerdings eine Grenze: Bei einem Mischpult spielt Wiederholung keine Rolle. Im Training wird ein Regler dagegen so oft nachgestellt, wie ein Text vorkommt. Wenn das Modell einen Satz fortsetzt, entsteht diese Fortsetzung jedes Mal neu. Damit geht es um die zweite Stelle: das Modell selbst.
Die Regler können aber so eingestellt sein, dass das Modell einen Text wörtlich fortsetzt. Stell dir einen Liedtext vor, der oft im Netz zitiert wird: Das Modell könnte in seiner Antwort die nächste Zeile wortgetreu wiedergeben. Das ist ein ausgedachtes Beispiel. Die Forschung nennt dieses wörtliche Wiedergeben Memorierung. Carlini und andere zeigten, dass sie mit der Modellgröße wächst, mit der Zahl der Wiederholungen eines Textes im Training und mit der Länge des Kontexts. Die Messungen stammen von älteren Modellen; eine Zahl für heutige Chatbots gibt es nicht.
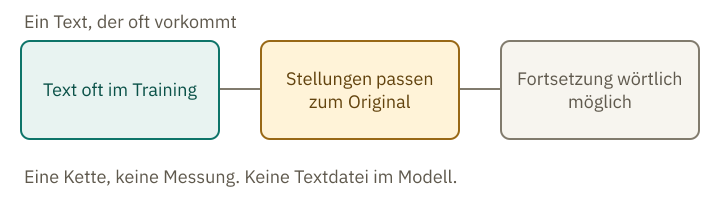
Doppelte Texte aus den Trainingsdaten zu entfernen, verkleinert das Problem. Das heißt Entduplizierung oder Deduplizierung. Lee und andere fanden 2021: Ohne Entduplizierung waren über 1 Prozent der Tokens, die das Modell ohne Vorlage schrieb, wörtlich aus dem Trainingstext kopiert. Tokens sind kleine Textstücke, in die das Modell Text zerlegt. Mit entduplizierten Daten gaben die Modelle auswendig gelernten Text rund zehnmal seltener wieder. Diese Messung legt nahe, dass Entduplizierung hilft.
Nasr und andere zeigten, dass Angriffe Trainingstext aus Chatmodellen herausholen können, und dass Verfahren, die das Modell auf Gespräche abstimmen, die Memorierung nicht vollständig beseitigen. Im normalen Gebrauch wurde das nicht gemessen.
Die dritte Stelle ist die Antwort. Sie entsteht bei jeder Frage neu. Fällt sie wörtlich aus, ist das eine Wiedergabe im Gespräch, auch wenn kein Text als Datei im Modell liegt. Ob eine solche Wiedergabe rechtlich eine Vervielfältigung ist, klären die Gerichte gerade.
Der Bundesgerichtshof, das oberste deutsche Zivilgericht, hat noch nicht entschieden, ob Stellungen als Kopie gelten. Das Landgericht München I hat es bei Liedtexten, die ein Modell wörtlich wiedergeben kann, als Kopie gewertet; das Urteil kann noch angefochten werden.
Gerichte, die noch entscheiden
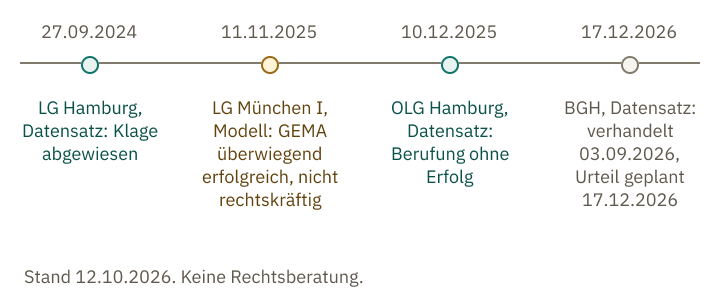
Stand: 12. Oktober 2026. Keine Rechtsberatung. Die Verfahren laufen oder können noch angefochten werden, und sie betreffen unterschiedliche Fragen.
Beim Datensatz: Im Verfahren um einen Datensatz eines gemeinnützigen Vereins hat das Landgericht Hamburg am 27. September 2024 die Klage abgewiesen. Der Datensatz enthält nur Links und Bildbeschreibungen, keine Bilder. Streitig war das Kopieren eines Vorschaubilds einer Fotografie beim Erstellen des Datensatzes, nicht das Modell. Das Hanseatische Oberlandesgericht hat die Berufung am 10. Dezember 2025 zurückgewiesen.
Beim Modell: Am 11. November 2025 hat das Landgericht München I der GEMA im Verfahren gegen OpenAI im Wesentlichen recht gegeben. Die GEMA ist eine Verwertungsgesellschaft, die Rechte an Musik vertritt. OpenAI ist das Unternehmen hinter ChatGPT. Es ging um Liedtexte, die die Modelle nach Ansicht des Gerichts wörtlich wiedergeben können. Das Gericht behandelte das als Memorierung und als Vervielfältigung. Nach Ansicht des Gerichts greift die Ausnahme für Text und Data Mining nicht für ein Training, das die Liedtexte wiedergibt. Eine analoge Anwendung der Ausnahme, also ihre Übertragung auf ähnliche Fälle, lehnte es ab. Das Urteil ist nicht rechtskräftig: Gegen das Urteil kann noch Rechtsmittel eingelegt werden; es ist also noch nicht endgültig.
Beim BGH: Das Verfahren um diesen Datensatz läuft beim Bundesgerichtshof unter dem Aktenzeichen I ZR 281/25. Die Verhandlung fand am 3. September 2026 statt. Das Urteil soll am 17. Dezember 2026 verkündet, also bekanntgegeben werden. Auch dieser Fall betrifft den Datensatz, nicht das Modell.
Auch die EU-Regeln für KI-Modelle greifen. Die KI-Verordnung verlangt von Anbietern von KI-Modellen mit allgemeinem Verwendungszweck eine Strategie für das Urheberrecht und eine Zusammenfassung der für das Training verwendeten Inhalte. Seit dem 2. August 2025 gelten diese Pflichten, Bußgelder seit dem 2. August 2026. Die Zusammenfassung sagt, was verwendet wurde, nicht, ob es rechtens war.
Deine Chats
Was du einem Chatbot schreibst, ändert das fertige Modell beim Benutzen nicht. Das hast du im Baustein über Input und Output gesehen. Ob ein Gespräch später ins Training fließt, ist ein eigener Schritt. Manche Anbieter bieten dafür eine Einstellung, andere nicht; die Regel steht in der App und in den Bedingungen.
Ein Beispiel: Anthropic, der Hersteller von Claude, schreibt in seinen Verbraucherbedingungen (seit dem 8. Oktober 2025), dass Inhalte für das Training genutzt werden können, außer man widerspricht in den Kontoeinstellungen. Auch nach einem Widerspruch kann Anthropic Inhalte fürs Training nutzen, wenn du Feedback gibst (etwa Daumen hoch oder runter) oder wenn Inhalte zur Sicherheitsprüfung markiert werden. Prüfe deshalb die App-Einstellungen, bevor du sensible Texte nutzt.
Für Betrieb und Sicherheit kann der Anbieter Gespräche weiter aufbewahren; das steht in seinen Datenschutzhinweisen.
Übung · erst selbst lösen
Fünf Texte, drei Stellen
Ordne jeden Fall zwei Dingen zu: der Stelle, an der der Text berührt wird (Sammeln, Modell oder Antwort), und dem Hebel, der dort wirkt (Vorbehalt, Einstellung, Entduplizierung). Ein Fall kann mehrere Stellen haben.
a) Ein Blogbeitrag, öffentlich, ohne Vorbehalt in der robots.txt. b) Dein eigenes Chatgespräch, bei dem du das Training ausgeschaltet hast. c) Ein Liedtext, der im Netz oft zitiert wird. d) Ein eigenes Gedicht, das nur im Familienkreis geteilt wurde. e) Ein Foto, auf dessen Seite im Quelltext ein maschinenlesbarer Vorbehalt steht.
Auflösung anzeigen
a) An der Stelle Sammeln greift die Ausnahme für rechtmäßig zugängliche Werke, solange kein maschinenlesbarer Vorbehalt da ist. Der wirkende Hebel ist der Vorbehalt. Offen bleibt, wie Gerichte die Lage für das Modell bewerten.
b) An der Stelle Sammeln, wenn der Anbieter das Gespräch für späteres Training nutzt. Der wirkende Hebel ist die Einstellung. Die Aufbewahrung zu Betrieb und Sicherheit bleibt möglich.
c) An der Stelle Modell liegt der offene Punkt. Der Liedtext steht oft im Netz, und genau das kann die Memorierung verstärken. Der Hebel dort ist die Entduplizierung der Trainingsdaten; sie verkleinert das Problem. Das Landgericht München I hat das als Vervielfältigung gewertet; das Urteil kann noch angefochten werden. Der BGH-Fall betrifft den Datensatz, nicht das Modell.
d) Das Gedicht wurde nur im Familienkreis geteilt, ein Sammelprogramm erreicht es nicht. Die Ausnahme greift an der Stelle Sammeln daher nicht, und dort wirkt kein Hebel. Kopierst du es in einen Chat, entscheidet die Trainingseinstellung deines Kontos , ob die Eingabe fürs Training genutzt werden kann.
e) An der Stelle Sammeln wirkt der maschinenlesbare Vorbehalt nach § 44b Abs. 3 UrhG für künftige Nutzungen des Fotos. Ob eine schon gesammelte Kopie davon betroffen ist, ist offen.
Die Auflösung ist eine Einordnung, keine Auskunft über einen konkreten Fall.
Für einen Blog wie deinen gilt nach dem Wortlaut von § 44b: Das Sammeln für Text und Data Mining war erlaubt, solange kein maschinenlesbarer Vorbehalt gesetzt war. Ob diese Erlaubnis auch das Training eines Modells mit solchen Kopien abdeckt, ist höchstrichterlich nicht geklärt. Das Landgericht München I hat sie für ein Training verneint, das Liedtexte wörtlich wiedergeben kann; das Urteil ist nicht rechtskräftig. Wie dein Fall zu beurteilen ist, hängt von den Umständen ab. Das Modell kann eine Passage wörtlich wiedergeben; ob das eine Vervielfältigung ist, bleibt offen. Taucht dein Satz in der Antwort auf, stellt sich die dritte rechtliche Frage. Auch sie hängt vom Einzelfall ab.
Beim Sammeln, im Modell und in der Antwort stellen sich jeweils eigene Fragen. Ob du etwas beeinflussen kannst, hängt vom passenden Hebel und vom Zeitpunkt ab. Dass ein Modell wörtlich zurückgeben kann, was es nie als Datei gespeichert hat, erklärt der Baustein über Vorhersagen und Nachplappern ausführlicher. Wie du Antworten auf Fehler prüfst, auch wenn die Quelle unklar ist, behandelt der nächste Baustein.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.