Baustein 2 von 9 · GrundlagenGelesen
Input und Output: Was ein Modell aus einer Eingabe macht
Was bekommt ein KI-Modell hinein, und was kommt heraus? Vom Spamfilter bis zum Chatbot: Oft kommt eine Liste von Bewertungen heraus.
Der Spamfilter aus dem vorigen Baustein hat eine überschaubare Aufgabe: Eine Mail geht hinein, am Ende steht ein Urteil. Bei einem Chatbot wirkt das anders. Du tippst eine Frage, und nach kurzer Zeit steht eine ganze, passende Antwort da. Wie kommt das zustande, wenn das Modell dahinter nur mit festen Zahlen rechnet?
Was hineingeht, was herauskommt
Schau dir den Spamfilter noch einmal genau an. Was hineingeht, heißt Input: hier eine Mail, genauer die Wörter darin. Was herauskommt, heißt Output. Beim Spamfilter ist der Output zunächst eine Zahl, aus der danach ganz am Ende das Urteil wird: Spam oder kein Spam. Der Filter zählt die Gewichte der Wörter zusammen. Bei „Gratis: Dein Gewinn wartet” sind das 2 für „gratis“ und 3 für „Gewinn“, zusammen 5. Erst der Vergleich mit der Schwelle macht daraus das Urteil. Die Schwelle ist eine eigene Zahl, 2 wie im vorigen Baustein: Liegt die Summe darüber, gilt die Mail als Spam.
Wie im vorigen Baustein gehören beide Schritte zum Filter: Das Zusammenzählen ergibt die Zahl, der Vergleich mit der Schwelle danach das Urteil. Beim Chatbot kommt ein weiterer Schritt hinzu: Das Modell bewertet jedes mögliche nächste Textstück, und dann wird eines davon gewählt. Der Spamfilter kannte nur zwei Ergebnisse. Der Chatbot hat dagegen bei jedem Schritt Tausende Textstücke zur Wahl, und eines davon wird genommen.
Beim Spamfilter aus dem vorigen Baustein ergibt gleicher Input immer dasselbe Urteil. Kommt dieselbe Mail zweimal, zählt der Filter zweimal dieselben Gewichte zusammen. Er erinnert sich nicht an die erste Mail und wird beim zweiten Mal nicht strenger. Die Gewichte ändern sich nur im Training. Das ist gewollt: Dieselbe Werbung soll heute nicht im Spam und morgen im Posteingang landen.
Ein vertrautes Gerät funktioniert genauso: der Taschenrechner. Du tippst „2 + 3”, er zeigt 5, heute, morgen und bei jedem anderen Menschen. Niemand erwartet, dass er heute so und morgen anders rechnet. Ein trainiertes Modell verhält sich in diesem Sinn genauso.
Sein Rechenweg steht fest, und seine Parameter (die gespeicherten Zahlen, wie die Gewichte des Spamfilters) stehen nach dem Training ebenfalls fest.
Der Spamfilter bekommt immer Text, ganz gleich wie lang, und gibt immer genau eine Zahl aus. Ein Foto könnte er gar nicht bewerten.
Der Taschenrechner-Vergleich hat Grenzen. Den Rechenweg eines Taschenrechners haben Menschen Schritt für Schritt gebaut. Beim Modell steckt das, was die Rechnung ausmacht, in Zahlen, die beim Training eingestellt wurden. Und ein Taschenrechner gibt eine einzige Zahl aus. Viele Modelle geben dagegen eine ganze Reihe von Zahlen aus. Die ganze Reihe zusammen ist ihr Output.
Eine Bewertung für jede Möglichkeit
Ein Spamfilter hat nur zwei mögliche Ergebnisse. Eine Bilderkennung soll ein Foto dagegen einer von vielen Kategorien zuordnen, etwa Katze, Hund, Fuchs oder Auto. Die Fachsprache sagt dazu Klassen. Ihr Input ist das Foto. Das Modell liest daraus die Helligkeit und die Farbe jedes Bildpunkts, also jedes Pixels. Ihr Output ist keine einzelne Zahl, sondern eine Zahl für jede Klasse.
So könnte das für das Foto einer Katze aussehen, mit ausgedachten Zahlen: Katze 6,2, Hund 2,9, Fuchs 1,4, Auto −3,0. Jede dieser Zahlen ist ein Score, eine Bewertung, wie gut die Klasse zum Bild passt. Je höher, desto besser. Wo der Nullpunkt liegt, spielt keine Rolle; es zählt, wie die Scores zueinander stehen. Welche Klasse am Ende auf dem Bildschirm steht, entscheidet wieder ein eigener Schritt: Er nimmt die Klasse mit dem höchsten Score. Auch beim Spamfilter waren das zwei getrennte Schritte. Das Modell bewertet, ein einfacher Schritt danach entscheidet.
Ähnlich funktioniert ein Sprachmodell, wie es hinter einem Chatbot steckt. Überleg kurz, bevor du weiterliest: Das Modell bekommt den Text „Die Katze sitzt”. Gibt es die fertige Antwort aus oder ein Wort?
Weder noch. Der Output eines Sprachmodells hat dieselbe Form wie bei der Bilderkennung, nur sind seine Klassen Textstücke. Ein Textstück ist ein ganzes Wort, ein Wortteil oder ein Satzzeichen. Für jedes Textstück, das es kennt, gibt es einen Score aus, wie gut dieses Stück als Nächstes passt. Mit ausgedachten Werten sieht ein Ausschnitt so aus:
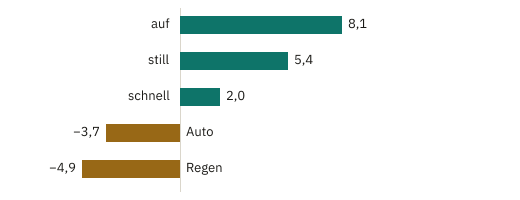
„auf” und „still” passen gut, „Regen” passt kaum. Die Liste ist in Wirklichkeit sehr lang. Das ältere Sprachmodell GPT-2, ein Vorläufer der Modelle hinter ChatGPT, kennt rund 50.000 Textstücke. Seine Score-Liste für das nächste Stück hat deshalb immer gleich viele Einträge, egal wie kurz oder lang der Input ist. Woher die Liste aller Textstücke kommt, klärt der nächste Baustein.
Wie aus einzelnen Stücken eine Antwort wird
Eine Runde bewertet nur das nächste Textstück, mehr nicht. Im Kern ist das Modell darauf trainiert, das nächste Textstück vorherzusagen. Ein Chatbot ist ein solches Modell, das zusätzlich darauf nachtrainiert wurde, auf Fragen hilfreich zu antworten. Eine ganze Antwort entsteht deshalb, indem sich derselbe kleine Ablauf immer wiederholt; man nennt ihn die Textschleife:
- Der bisherige Text geht als Input ins Modell.
- Das Modell gibt die Score-Liste aus.
- Ein Auswahlschritt macht daraus ein einziges Textstück.
- Dieses Stück wird an den Text angehängt, und der längere Text ist der Input der nächsten Runde.
Spiel drei Runden durch. Runde eins: Input „Die Katze sitzt”. Der Auswahlschritt nimmt hier einfach das Stück mit dem höchsten Score, also „auf” mit 8,1. Runde zwei: Input ist jetzt „Die Katze sitzt auf”. Das Modell rechnet die ganze Liste neu, und diesmal liegen andere Stücke vorn:
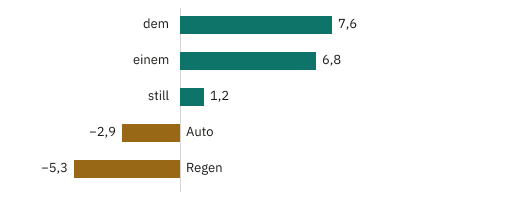
Vorn liegt jetzt „dem“, knapp vor „einem“. Gewählt wird also „dem“. Runde drei bekommt „Die Katze sitzt auf dem“. Diesmal liegt „Sofa“ vorn, deutlich vor „Tisch“ (ausgedachte Werte: 8,3 und 5,9). Gewählt wird also „Sofa“, und es wird angehängt.
Die Textschleife hört auf, wenn der Auswahlschritt ein besonderes Stopp-Zeichen nimmt, ein Zeichen, das das Ende eines Textes markiert. Daneben gibt es eine vorgegebene Längengrenze; wird sie erreicht, bricht die Schleife ab, auch mitten im Satz. Das Stopp-Zeichen steht auch in der Score-Liste, du siehst es im Chat nur nicht. Im Chat siehst du also nur das Ergebnis dieser Schleife, nie die Score-Listen dahinter. Dass das Modell das Stopp-Zeichen hoch bewertet, liegt am Training: Dort enden viele Texte mit einem solchen Zeichen, und das Modell lernt so, es nach dem letzten Stück eines Textes hoch zu bewerten.
Was die Schleife im Chatfenster erklärt
Die Textschleife erklärt drei Dinge, die du bei Chatbots beobachten kannst. Erstens erscheint die Antwort oft in kleinen Stücken, fast Wort für Wort, weil sie so entsteht. Zweitens nimmt das Modell im üblichen Ablauf ein gewähltes Stück nicht zurück. Es bleibt stehen, und alle folgenden Runden rechnen mit ihm weiter. Ein früh gewähltes, unpassendes Stück prägt deshalb den Rest der Antwort. Hätte Runde zwei „einem“ gewählt, ginge es mit „Die Katze sitzt auf einem“ weiter. Ein Zurück zu „dem“ gibt es dabei nicht.
Drittens kann dieselbe Frage zweimal verschieden beantwortet werden. Auf dem Papier ergibt gleicher Input dieselbe Score-Liste; im Rechenzentrum kommen winzige Rechenunterschiede dazu (mehr dazu in der Box unten). Einen großen Teil des Unterschieds, den du siehst, macht der Auswahlschritt. Beim Spamfilter ist dieser Schritt ein fester Schwellenvergleich. Viele Chatbots nehmen nicht immer das Stück mit dem höchsten Score, sondern wählen mit etwas Zufall. Das macht die Antworten abwechslungsreicher: Dieselbe Frage bekommt nicht jedes Mal denselben Wortlaut. Bei „Die Katze sitzt“ wäre auch „still“ (5,4) möglich, nicht nur „auf“ (8,1), nur seltener. Das höher bewertete Stück hat eine größere, aber keine sichere Chance; auch niedriger bewertete Stücke können gewählt werden.
Eine Ebene tiefer: Wie im Rechenzentrum winzige Rechenunterschiede entstehen
Im Rechenzentrum können winzige Rundungsunterschiede die Scores an der letzten Stelle verschieben. Für die Auswahl macht das nur dann einen Unterschied, wenn zwei Stücke fast gleichauf liegen.
Ein Computer speichert Kommazahlen als sogenannte Gleitkommazahlen, mit einer festen Zahl von Stellen. Was nicht hineinpasst, wird gerundet. Gespeichert wird im Zweiersystem, also nur mit Nullen und Einsen. Schon 0,1 lässt sich so nicht exakt speichern, ähnlich wie 1/3 im Zehnersystem als 0,333… nie endet. Diese Rundung hat eine überraschende Folge: Beim Addieren kommt es darauf an, welche Zahlen zuerst zusammengezählt werden. Nimm a = 0,1, b = 0,2 und c = 0,3 einmal (a + b) + c, also erst a und b, und einmal a + (b + c), also erst b und c. Die Programmiersprache Python zeigt links 0,6000000000000001 und rechts 0,6 an. Die beiden Ergebnisse unterscheiden sich an der letzten gespeicherten Stelle. Mathematisch sind beide gleich.
Für jede Score-Liste addiert ein Sprachmodell riesige Mengen solcher Zahlen. Dabei werden Anfragen vieler Menschen gemeinsam berechnet, als ein sogenannter Batch. Die Reihenfolge der Rechenschritte kann von der Größe dieses Batches abhängen. Die Größe hängt von der Auslastung ab, also davon, wie viele Menschen gerade gleichzeitig Anfragen stellen. Ändert sie sich, ändert sich auch die Reihenfolge der Additionen, und die Scores weichen an den letzten Stellen ab.
Meist bleibt das folgenlos. Liegen zwei Stücke aber fast gleichauf, kann schon ein winziger Unterschied entscheiden, welches vorn liegt. Das Forschungsunternehmen Thinking Machines Lab hat es ausprobiert: Ein Modell beantwortete dieselbe Anfrage 1000-mal, immer mit dem Stück mit dem höchsten Score, und lieferte 80 verschiedene Antworten. Jede war 1000 Textstücke lang. Alle stimmten in den ersten 102 Stücken überein, erst dann trennten sich die Wege.
Nur die Ausführung kann abweichen: Der Computer rechnet dieselben Schritte in anderer Reihenfolge und rundet an der letzten Stelle minimal anders.
Bei einem Chatbot geht dein Text, der Prompt, zusammen mit einer Systemanweisung in die erste Runde. Die Systemanweisung enthält Vorgaben dazu, wie sich das Modell verhalten soll. Der Input ist dann das ganze Gespräch, Nachricht für Nachricht: deine Fragen, die bisherigen Antworten des Modells und die Systemanweisung, jeweils mit der Angabe, wer sie geschrieben hat. Vorher wird all das für das Modell zu einer einzigen Folge von Textstücken zusammengesetzt. Steuerzeichen dazwischen zeigen an, wer geschrieben hat. Die Antwort wird Stück für Stück hinten angehängt.
Live-Demo · zum Ausprobieren
Die Textschleife, Runde für Runde
Der bisherige Text geht hinein, eine Score-Liste kommt heraus, ein Stück wird gewählt und angehängt. Schau dir die Score-Liste an und rate, welches Stück gewählt wird. Dann drück „Nächstes Stück“ und prüf, ob du richtig lagst.
Bisherige Durchläufe
Alle Scores sind ausgedacht. Die ersten beiden Listen sind die aus dem Text; die Fortsetzung ist frei erfunden. Die Prozentwerte bei „Mit etwas Zufall“ sind keine Messung: Sie ergeben sich aus diesen ausgedachten Scores mit einer frei gewählten Rechenregel. „< 0,1 %“ heißt: weniger als ein Zehntel Prozent. Solche Reste gehören zu den 100 %, ihr Wert steht nicht da.
Woher die Scores kommen, und was im Chat fehlt
Woher weiß das Modell, dass nach „Die Katze sitzt” eher „auf” passt als „Regen”? Die Antwort kennst du aus dem vorigen Baustein: Beim Spamfilter hatten Menschen in den Trainingsbeispielen markiert, was richtig ist. Das richtige nächste Textstück zu einem Trainingsbeispiel heißt in der Fachsprache Label. Ein Trainingsbeispiel besteht aus einem Input und diesem Label. Der Trainingsalgorithmus vergleicht, was das Modell ausgibt, mit dem Label und stellt die Parameter ein kleines Stück nach.
Beim Spamfilter mussten Menschen jede Mail als Spam oder normale Post markieren. Beim Sprachmodell steckt das Label schon im Text selbst. Nimm einen ganz gewöhnlichen Satz: „Die Katze sitzt auf dem Sofa.” Aus ihm lassen sich gleich mehrere Trainingsbeispiele bilden.
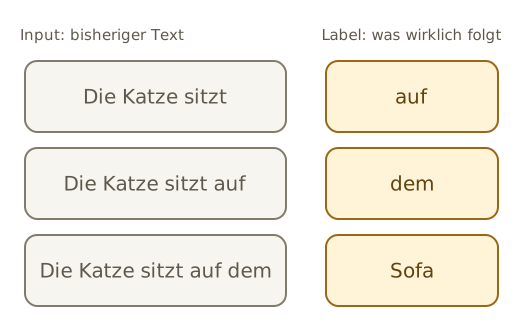
Der Input ist jeweils der Anfang, das Label das Stück, das tatsächlich folgt: Zu „Die Katze sitzt” gehört das Label „auf”, zu „Die Katze sitzt auf” das Label „dem”. Der Trainingsalgorithmus schaut, welchen Score das Modell dem richtigen Stück gegeben hat. Das richtige Stück soll möglichst weit vorn liegen. Er stellt die Parameter so nach, dass es beim nächsten Mal höher bewertet wird. Liegt es schon weit vorn, ist nur eine kleine Korrektur nötig.
Weil jeder Text auf diese Weise viele Beispiele liefert, lässt sich ein Sprachmodell mit riesigen Textmengen trainieren. Dafür braucht niemand Labels von Hand: Das nächste Stück im Text ist das Label. Dieses Training, bei dem das Modell nur lernt, das nächste Stück vorherzusagen, heißt Grundtraining.
Eine Ebene tiefer: Das Nachtraining, das aus dem Modell einen Chatbot macht
Nach dem Grundtraining folgt oft ein zweites Training, das Nachtraining. Dafür sammeln Menschen Beispiele, die sie selbst geschrieben oder bewertet haben: eine Frage mit einer guten Antwort, oder mehrere Antworten, die jemand nach Hilfsbereitschaft ordnet. Das Modell lernt daraus, auf Fragen wie ein hilfreicher Chatbot zu antworten, statt den Text nur fortzusetzen.
Das Grundtraining legt fest, was das Modell über Sprache weiß. Das Nachtraining verschiebt die Antworten in eine Richtung, die Menschen als hilfreich empfinden. Auch hier werden die Parameter angepasst, nur mit anderen Beispielen als beim Grundtraining. Das Ergebnis heißt dann oft Instruktionsmodell, weil es Anweisungen befolgen soll.
Ein bekanntes Beispiel ist InstructGPT von OpenAI aus dem Jahr 2022. Dort wurde ein Modell aus der GPT-3-Familie mit von Menschen geschriebenen Beispielantworten und mit menschlichen Bewertungen von Antworten nachtrainiert.
Wenn du das Modell benutzt, fehlt das Label. Stellst du einem Chatbot eine Frage, ist kein „richtiges“ nächstes Stück vorgegeben. Deshalb gibt es nichts zu vergleichen. Das Modell rechnet nur mit den Parametern, die das Training hinterlassen hat. Dein Gespräch verändert das Modell nicht, während du chattest. Dass ein Chatbot im Gespräch auf frühere Nachrichten eingeht, heißt nicht, dass er dazulernt. Der bisherige Verlauf wird einfach jedes Mal wieder als Input mitgeschickt. Ein neues Gespräch beginnt meist ohne den alten Verlauf. Manche Chatbots speichern Angaben und schicken sie bei späteren Gesprächen wieder mit.
Wie beim Spamfilter entstehen neue Fassungen eines Modells erst in eigenen, späteren Trainingsläufen.
Ein Modell rechnet nur mit festen Zahlen, und trotzdem entsteht eine Antwort: Es bewertet das nächste Textstück, ein Auswahlschritt wählt eins aus, und der verlängerte Text geht in die nächste Runde. Wie aus „Die Katze sitzt” überhaupt Zahlen werden, zeigt der nächste Baustein.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.