Baustein 3 von 9 · GrundlagenGelesen
Tokenizer: Wie Text in Tokens zerfällt
Zeigt, wie ein Tokenizer Text in Stücke zerlegt, die er vorher durch Zählen gelernt hat, und warum die Zahl der Tokens nicht die Zahl der Wörter ist.
Bevor du weiterliest, teile dieses Wort im Kopf in Stücke: „unwahrscheinlich“. Machst du daraus ein einziges Stück, drei verständliche Teile wie „un“, „wahr“ und „scheinlich“ oder lauter einzelne Buchstaben? Halte deine Wahl fest.
Im vorigen Baustein bekam ein Sprachmodell als Input einen Textanfang wie „Die Katze sitzt“ und gab für jedes Textstück, das es kennt, einen Score aus. Offen blieb, wie aus Text etwas wird, womit ein Modell rechnen kann. Was ist ein Textstück genau, und wer hat festgelegt, welche Stücke es gibt?
Warum das Modell eine feste Liste von Stücken braucht
Warum nimmt ein Sprachmodell deinen Text nicht einfach so, wie er kommt? Das ältere Sprachmodell GPT-2 kennt 50.257 Textstücke, und seine Score-Liste hat immer genau 50.257 Einträge, einen für jedes Stück. Es geht ihm wie der Bilderkennung aus dem vorigen Baustein: Sie gibt immer genau einen Score für Katze, Hund, Fuchs und Auto aus und kann keine neue Klasse anlegen. Auch beim Sprachmodell steht die Form des Outputs fest, bevor es rechnet. Die Score-Liste lässt sich also nur bauen, wenn vorher feststeht, welche Stücke es gibt.
Dasselbe gilt für den Input. Jedes Modell rechnet nur mit der Art von Input, für die es gebaut ist: Das Sprachmodell kann nur Stücke aus seiner festen Stückliste verarbeiten, dem Vokabular. Die Score-Liste ist etwas anderes: Sie wird für jeden Input neu berechnet und hat für jedes Stück im Vokabular einen Eintrag. Deshalb muss auch deine Frage zuerst in Stücke aus dem Vokabular zerlegt werden. Jedes dieser Stücke heißt Token.
Jede Nachricht, die du schickst, wird vorher in Stücke geschnitten, bevor sie das Modell erreicht, und auch jede Antwort besteht aus solchen Stücken. Wo die Schnitte liegen, steht also fest, bevor das Modell auch nur eine Zahl berechnet. Welche Stücke soll die Liste enthalten?
Ganze Wörter oder einzelne Buchstaben?
Bevor dein Text ins Modell geht, zerlegt ihn ein eigenes Programm, der Tokenizer. Wenn jedes Wort ein Token wird, funktioniert das für eine begrenzte Sammlung von Texten, aber nicht für beliebige Texte. Die Liste bräuchte „Haus“, „Haustür“, „Haustürschlüssel“ und jede weitere Zusammensetzung, dazu gebeugte Formen wie „lernen“, „lernt“ und „gelernt“, Namen, Tippfehler und Wörter, die morgen neu entstehen. Sie kann groß werden, aber sie bleibt endlich. Was fehlt, könnte nur als Platzhalter „unbekannt“ hinein. Beim Regelfilter aus dem ersten Baustein griff die Gewinn-Regel nicht mehr, sobald im Betreff „G3WINN“ statt „Gewinn“ stand. Ein Chatbot mit fester Wortliste sähe ebenso bei jedem neuen Bandnamen nur „unbekannt“.
Eine andere Möglichkeit ist, jeden Buchstaben, jedes Leerzeichen und jedes Satzzeichen als eigenes Token zu nehmen. Damit lässt sich jedes Wort zusammensetzen, auch ein völlig neues, und die Liste bleibt klein. Dafür wird der Input lang. Das Modell erhält den Input als Folge von Tokens, und jedes Token belegt einen Platz. „Die Katze sitzt.“ belegt mit Leerzeichen und Punkt 16 Plätze, und selbst ein häufiges „sch“ belegt jedes Mal drei. Auch die Antwort entstünde Buchstabe für Buchstabe, mit einer Runde der Schleife für jedes Zeichen.
Ganze Wörter sind zu starr, einzelne Zeichen zu kleinteilig.
Der Mittelweg: wiederverwendbare Wortstücke
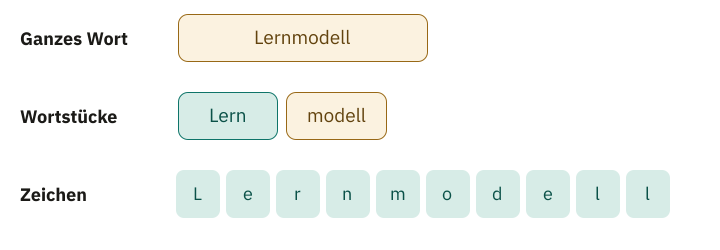
Viele Tokenizer arbeiten deshalb mit Subword-Tokens, also Wortstücken. Ein Token kann ein ganzes häufiges Wort sein, ein wiederkehrender Wortteil oder ein einzelnes Zeichen. So arbeiten auch die Tokenizer hinter Chatbots wie ChatGPT. „Lernmodell“ könnte etwa in „Lern“ und „modell“ zerfallen. Das ist ein Denkbeispiel; jeder Tokenizer zerlegt anders.
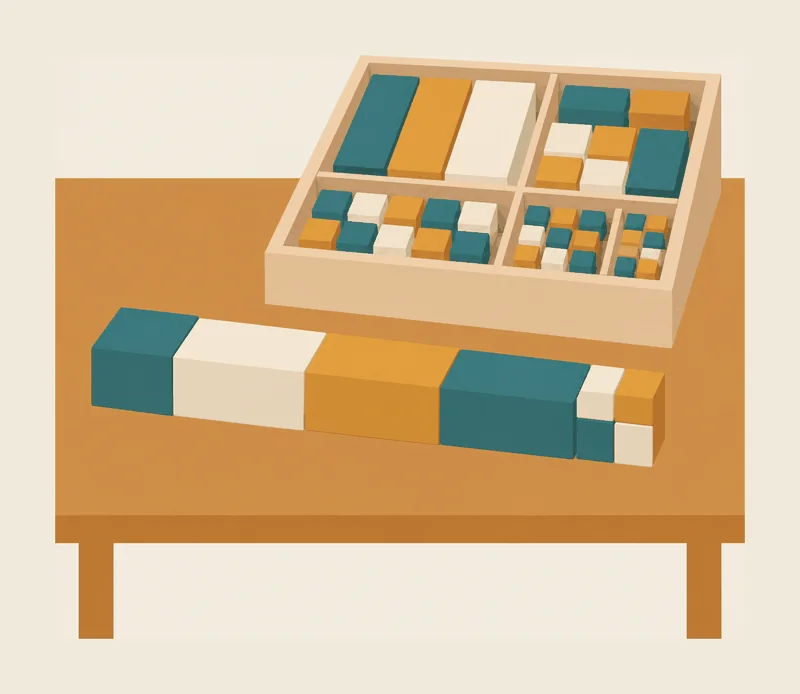
Das funktioniert wie ein Baukasten. Häufiges liegt als großer fertiger Klotz bereit, Seltenes wird aus kleinen Klötzen zusammengesetzt, notfalls aus einzelnen Zeichen. So fällt kein Wort durch, und häufige Wörter belegen trotzdem nur wenige Plätze. Ein neues Wort muss dafür nicht bekannt sein; es entsteht aus Teilen, die schon im Kasten liegen. Die gebaute Reihe ist die Tokenfolge deines Textes; sie entsteht für jeden Text neu. Der Kasten selbst bleibt dagegen immer derselbe: Er ist das Vokabular, die feste Liste aller Stücke, die ein Tokenizer kennt. Bei GPT-2 sind es 50.257 Stücke.
Doch der Vergleich hat eine Grenze: Beim Baukasten entscheidest du selbst, welchen Klotz du nimmst. Der Tokenizer entscheidet nicht, sondern folgt festen Regeln. Auch die Form der Klötze richtet sich nicht nach ihrer Bedeutung; ein Zählverfahren bestimmt, welche Stücke im Kasten landen.
Woher die Stücke kommen: zählen und verschmelzen
Der Tokenizer von GPT-2 hat seine Stücke mit einem Verfahren gelernt, das Byte Pair Encoding heißt, kurz BPE. „Pair“ heißt „Paar“. Gelernt heißt hier etwas anderes als beim Spamfilter, dessen Gewichte nach Fehlern nachgestellt wurden. BPE kennt weder Fehler noch Gewichte.
Am Anfang enthält das Vokabular nur Grundbausteine. Im einfachen Beispiel sind das einzelne Zeichen, bei GPT-2 dagegen die Bytes. Davon gibt es nur 256 verschiedene, kleine Speicherbausteine im Computer; aus ihnen setzt ein Computer jedes Zeichen zusammen, auch ein nie gesehenes. Zuerst zählt das Verfahren in einer Textsammlung, dem Übungstext, wie oft zwei Stücke direkt nebeneinanderstehen. Dann verschmilzt es das häufigste Paar zu einem neuen Stück. Dieses Stück kommt als Eintrag ins Vokabular. Jede Verschmelzung notiert das Verfahren als nummerierte Regel.
Die Regeln des Regelfilters aus dem ersten Baustein hatten Menschen geschrieben. Hier dagegen entstehen lesbare Regeln allein durch Zählen; kein Mensch formuliert sie. Der Tokenizer ist ein Programm, das diese Regeln nacheinander abarbeitet, ohne Gewichte, die nach Fehlern nachgestellt werden. Danach zählt das Verfahren erneut, nun mit dem neuen Stück. Das geht so lange, bis das Vokabular die vorher gewählte Größe erreicht. Echte Tokenizer lernen so Zehntausende Regeln.
Ein ausgedachter Übungstext besteht aus neun Wörtern: „lachen“ und „machen“ je zweimal, „sagen“ dreimal, „nicht“ und „lacht“ je einmal. Die Wörter sind ausgedacht, die Zählung ist echt. Jede Zählung kannst du auf dem Papier nachprüfen. Das Verfahren zählt nur Paare innerhalb eines Wortes. Welches Paar kommt wohl am häufigsten vor? Überleg kurz, bevor du weiterliest.
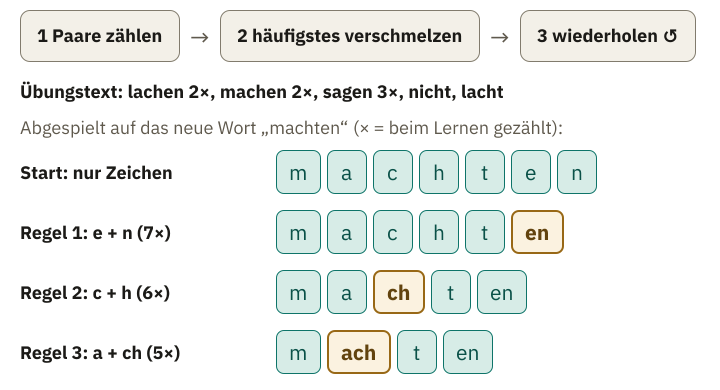
Es ist „e“ + „n“, 7-mal: „lachen“ und „machen“ je zweimal, „sagen“ dreimal. In jedem dieser Wörter steckt es genau einmal. Damit wird „en“ zur ersten Regel.
Die zweite und dritte Regel
Danach zählt das Verfahren neu, denn der Übungstext besteht jetzt aus anderen Stücken. „lachen“ ist l | a | c | h | en, „machen“ m | a | c | h | en und „sagen“ s | a | g | en. Dazu kommen „nicht“ als n | i | c | h | t und „lacht“ als l | a | c | h | t. Welches Paar ist jetzt das häufigste? Zähl nach, bevor du weiterliest.
Am häufigsten ist jetzt „c“ + „h“, 6-mal: in „lachen“ und „machen“ je zweimal, in „nicht“ und „lacht“ je einmal. Das wird die zweite Regel, „ch“.
Nach Regel 2 wird „lachen“ zu l | a | ch | en und „machen“ zu m | a | ch | en. „sagen“ bleibt unverändert, weil es kein „ch“ enthält. „nicht“ wird zu n | i | ch | t und „lacht“ zu l | a | ch | t.
Beim dritten Zählen steht „ch“ fünfmal hinter einem „a“: in „lachen“ und „machen“ je zweimal, in „lacht“ einmal. Die dritte Regel verschmilzt beide zu „ach“.
Eine Ebene tiefer: Wie geht es weiter?
Das Verfahren zählt nach jeder Regel neu und verschmilzt weiter, bis das Vokabular seine Größe erreicht. Nach der dritten Regel ist das häufigste Paar „ach“ + „en“, 4-mal: „lachen“ und „machen“ kommen je zweimal vor, und in jedem steckt „ach“ vor „en“. Der Übungstext zeigt nur die drei Regeln, damit das Beispiel überschaubar bleibt. Bei echten Trainingstexten läuft dieselbe Zählung über riesige Mengen Text, und es entsteht eine lange Liste von Regeln. Die Reihenfolge ist dabei wichtig: Jede Regel baut auf den Stücken auf, die frühere Regeln geschaffen haben. Deshalb verschmilzt das Verfahren nicht alle Paare gleichzeitig, sondern eines nach dem anderen, und zählt nach jedem Schritt neu. Am Ende hat jedes Stück seinen festen Platz im Vokabular, und die Liste der Regeln bestimmt, wie ein neuer Text zerlegt wird.
Das Verfahren findet damit Stücke, die wie deutsche Wortteile aussehen. Was eine Endung ist, weiß es trotzdem nicht: „en“ und „ach“ wurden Regeln, weil sie häufig waren.
Echte Tokenizer zählen genauso, nur in riesigen Textmengen.
Eine Ebene tiefer: Wie BPE ohne „unbekannt“ auskommt
Byte Pair Encoding war ursprünglich ein Verfahren zur Datenkompression, das häufige Paare von Bytes durch ein einzelnes neues Zeichen ersetzt. Jedes sichtbare Zeichen wird durch ein oder mehrere Bytes dargestellt, ein Umlaut oder Emoji durch mehrere. Für die maschinelle Übersetzung wurde BPE so angepasst, dass es Zeichen statt Bytes verschmilzt.
Bei einem Tokenizer, der mit Zeichen beginnt, bleibt ein Problem: Ein Zeichen, das im Übungstext nie vorkam, steht nicht im Grundvokabular und gilt daher als „unbekannt“. Ein Grundvokabular mit allen Schriftzeichen der Welt hätte über 130.000 Einträge. Byte-Level-BPE, wie bei GPT-2, beginnt deshalb mit Bytes. Davon gibt es nur 256 verschiedene, und alle passen ins Grundvokabular. Selbst ein nie gesehenes Schriftzeichen lässt sich so aus Bytes zusammensetzen. Das fertige Vokabular umfasst das Grundvokabular und zusätzlich einen Eintrag für jede gelernte Regel. Manchmal kommen Sondereinträge dazu, etwa Marken für Rollen im Chat. Was sie bedeuten, erklärt der Baustein Tokenisierung im Modell.
BPE ist nicht das einzige Verfahren für Wortstücke. SentencePiece lernt Wortstücke, auch mit BPE, direkt aus rohen Sätzen. Es zerlegt die Sätze vorher nicht an vermuteten Wortgrenzen. Das hilft bei Sprachen, die Wortgrenzen nicht wie das Deutsche mit Leerzeichen markieren.
Wie der fertige Tokenizer ein neues Wort zerlegt
Was macht der fertige Tokenizer mit einem Wort, das im Übungstext nie vorkam, etwa „machten“? Rate, bevor du weiterliest, in welche Stücke es mit den drei Regeln zerfällt.
Der Tokenizer zählt nicht neu. Er teilt das Wort in einzelne Zeichen und spielt seine drei Regeln in der gelernten Reihenfolge ab. Zuerst macht Regel 1 aus „e“ + „n“ das Stück „en“: m | a | c | h | t | en. Danach bildet Regel 2 aus „c“ + „h“ das Stück „ch“: m | a | ch | t | en. Zuletzt verbindet Regel 3 „a“ und „ch“: m | ach | t | en. Für das „m“ und das „t“ gibt es keine Regel, sie bleiben einzelne Zeichen.
Jedes Zeichen des Übungstexts stand schon am Anfang im Vokabular. Deshalb fällt kein Wort aus diesen Zeichen durch; Unbekanntes zerfällt nur in kleinere Stücke. Der Tokenizer von GPT-2 setzt notfalls jedes Zeichen aus noch kleineren Bausteinen zusammen, den Bytes, mit denen ein Computer Zeichen speichert (mehr dazu in der Box oben). Bei ihm bleibt deshalb gar nichts unbekannt. Und weil Regeln und Reihenfolge feststehen, ergibt derselbe Text mit demselben Tokenizer immer dieselben Tokens. Schickst du dieselbe Frage in zwei neuen Chats ab, werden aus ihr beide Male dieselben Tokens. Zu verschiedenen Antworten kommt es fast immer erst danach: beim Auswahlschritt, in dem mit etwas Zufall ein Stück aus der Score-Liste des Modells gewählt wird.
Und „unwahrscheinlich“ vom Anfang? Der echte Tokenizer von GPT-2 macht daraus sieben Stücke: „un“, „w“, „ah“, „r“, „sche“, „in“ und „lich“. Die Token-Grenzen durchschneiden sogar „wahr“, denn der echte Tokenizer hat kein Stück „wahr“ gelernt. Seine Regeln sind andere als die drei aus dem Übungstext.
Im Werkzeug lernt dein eigener Tokenizer nach demselben Ablauf aus einem längeren Übungstext. Danach zerlegt er einen Satz, den du eintippst.
Live-Demo · zum Ausprobieren
Bau dir einen Tokenizer
Echter Tokenizer, kein ModellHier entsteht ein echter Tokenizer. Er beginnt mit den einzelnen Zeichen eines kleinen Übungstexts und lernt Schritt für Schritt, welche Nachbarn er zu einem neuen Stück verschmilzt. Danach zerlegt er deinen eigenen Satz. Das Zeichen ␣ steht für ein Leerzeichen; es gehört zum folgenden Wort, Paare über Wortgrenzen hinweg zählen nicht.
Probier es aus: Drück dreimal „Nächster Schritt“; das sind die drei Regeln aus dem Text. Bevor du ein viertes Mal drückst, rate: Bleibt der Zweitplatzierte vorn, oder überholt ihn ein Paar mit dem neuen Stück „ach“, etwa „ach“ + „en“?
Häufigste Paare
- Noch nicht gezählt.
Vokabular
Am Anfang: einzelne Zeichen, Nr. 0–29: , . D E G I K L M S W a c d e g h i l m n r s t u w z ä ü ␣
Probier es aus: Wird „Katzen“ ein Stück oder mehrere? Und was passiert mit einem Wort, das im Übungstext nie vorkommt? Rate erst, dann tipp es ein.
Abspiel-Schritte zeigen
Zum Vergleich: der echte GPT-2-Tokenizer
Wird beim Öffnen geladen …
Auflösung
Die ersten drei Regeln sind dieselben wie im Text, „en“, „ch“ und „ach“, nur mit größeren Zählungen (35, 22 und 17). Die vierte ist „i“ + „e“, 13-mal: Die kurzen Wörter „Die“, „Sie“ und „die“ kommen im Übungstext ständig vor. Ein anderer Übungstext ergäbe andere Regeln; deshalb zerlegt der echte GPT-2-Tokenizer deinen Satz oft anders als dieser Mini-Tokenizer.
Der Übungstext aus 24 kurzen Sätzen ist ausgedacht, gezählt und verschmolzen wird echt. Am Anfang besteht das Vokabular aus seinen 30 Zeichen; ein Zeichen, das darin fehlt, bleibt deshalb „unbekannt“. Stehen zwei Paare gleich oft da, gewinnt das, das im Übungstext zuerst vorkommt. Die kleine Zahl unter jedem Stück ist seine Nummer im Vokabular; was das Modell damit anfängt, zeigt der nächste Baustein. Der echte Tokenizer von GPT-2 hat aus riesigen Textmengen gelernt und kennt 50.257 Stücke; der Vergleich nutzt seinen öffentlich verfügbaren Tokenizer.
Warum Tokens keine Wörter sind
Sprachmodelle messen die Länge eines Textes in Tokens, nicht in Wörtern. Sind das dieselben Zahlen?
Wer Sprachmodelle direkt aus eigenen Programmen nutzt, zahlt meist pro Token. Der Tokenizer von GPT-2 zerlegt „Die Hauptstadt von Frankreich ist“ in 10 Tokens und „The capital of France is“ in 5. Beide Sätze haben fünf Wörter. „France“ ist bei GPT-2 ein einziges Stück, „Frankreich“ wird zu „Frank“, „re“ und „ich“.
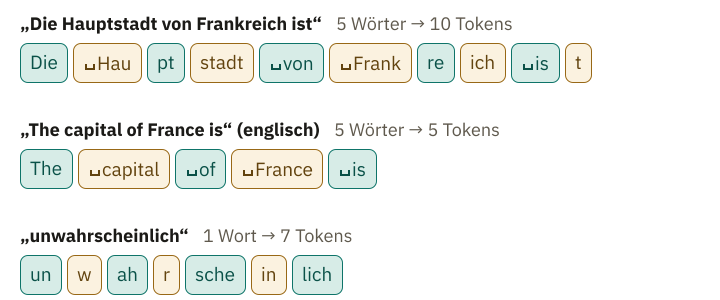
Probier es im Werkzeug oben aus: Gib in Schritt 2 erst den deutschen und dann den englischen Satz ein. Vergleiche, wie viele Tokens GPT-2 jeweils braucht, und gib danach „Frankkreich“ ein.
Was beim Zählen häufig war, wurde zu großen Stücken. Im gemessenen Beispiel ist „France“ ein Token, „Frankreich“ zerfällt in drei. Schon ein Tippfehler kann die Zahl erhöhen: „Frankkreich“ braucht ein Stück mehr als „Frankreich“.
Eine Ebene tiefer: Auf welchen Texten zählt GPT-2?
Der Tokenizer von GPT-2 entstand für ein Modell, dessen Trainingstexte OpenAI nicht veröffentlicht hat. Welche Texte er zum Zählen seiner Paare benutzt hat, ist nicht öffentlich aufgelistet. Ein Nachbauprojekt berichtet, dass nicht-englische Seiten entfernt wurden; ob das die Paare geprägt hat, ist nicht belegt. Daraus folgt für dich: Welche Stücke ein Tokenizer hat, spiegelt vor allem, was in den Zähltexten häufig war. Ob diese Texte viele deutsche Wörter enthielten, lässt sich aus der Liste der Stücke nur indirekt ablesen. Der Haupttext zeigt, wie das bei englischen und deutschen Wörtern aussieht. Wichtig ist dabei: Die Liste ist fest, sobald der Tokenizer gebaut ist. Jeder Text, auch ein neuer, wird danach mit genau dieser Liste zerlegt, egal woher er stammt.
Mit mehr Tokens wird der Input länger. Oft hört man, ein Modell verstehe ein Wort schlechter, wenn es in viele Tokens zerfällt. Das klingt plausibel, weil ein ganzes Stück vollständiger wirkt als Bruchstücke. Die Zahl allein sagt aber nichts über das Verständnis. Das Modell bekommt immer den gesamten Input auf einmal – wie „Die Katze sitzt auf“ im vorigen Baustein – und nicht nur das letzte Stück. Ob es aus mehreren Stücken eine Bedeutung gewinnt, hängt davon ab, was es im Training gelernt hat, etwa dass „Frank“, „re“ und „ich“ zusammen „Frankreich“ ergeben.
Von der Zahl der Tokens allein kannst du nicht auf das Verständnis schließen.
Der Tokenizer zerlegt Text nur in Stücke und bewertet nicht, ob sie zum Sinn passen.
Stücke sind noch keine Zahlen
Die Tokens sind immer noch Text, und ein Modell rechnet nur mit Zahlen. Welche Zahl jedes Stück bekommt und was diese Zahl dem Modell verrät, zeigt der nächste Baustein: Token-IDs: Was eine Nummer bedeutet.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.