Baustein 5 von 6 · Der Weg durchs ModellGelesen
Transformerblöcke und Attention: Wie Kontext eingemischt wird
Wie ein Sprachmodell die Information früherer Wörter in jedes Token einmischt, warum es nicht nach vorne schauen darf und wie viele Blöcke dabei arbeiten.
Zwei Sätze: „Ich zahle Geld bei der Bank ein“ und „Ich sitze auf der Bank im Park“. Im vorigen Baustein hat jedes Token, also jedes Textstück, sein Embedding bekommen, eine lange Zahlenliste aus der Nachschlagetabelle. Für „Bank“ ist sie in beiden Sätzen dieselbe. Ein Chatbot, der beide ins Englische übersetzt, muss aber einmal „bank“ und einmal „bench“ schreiben. Woher soll er das wissen?
Die Antwort steckt in vielen gleich gebauten Blöcken mit eigenen Zahlen. Diese 2017 vorgestellte Architektur heißt Transformer. Darin bekommt jedes Token Information von anderen Tokens.
Ein Embedding, zwei Bedeutungen
Wenn du „Ich sitze auf der Bank“ liest, denkst du nicht an Geld, weil du den Satz drumherum mitliest. Ein Embedding kann das nicht.
Ein Sprachmodell rechnet aus jedem Embedding Schritt für Schritt neue Zahlen; die Tabelle selbst bleibt unverändert. Wie beim Mischpult laufen die Zahlen durch viele Rechenstufen. Sie heißen Blöcke, in Modellangaben meist Schichten. Ein frei verfügbares Sprachmodell, Qwen3-8B, hat 36 davon; in ihnen steckt der größte Teil seiner Parameter.
Die Zwischenwerte eines Tokens heißen hier sein Zustand. Anfangs ist er das Embedding (bei GPT-2 plus Sitzplatz, dazu unten); jeder Block schreibt ihn fort. Messungen an älteren Modellen wie GPT-2 zeigen: In späteren Blöcken unterscheiden sich die Zustände desselben Wortes von Satz zu Satz meist stärker. Bei GPT-2 sind sie nach dem letzten Block fast vom Satz geprägt.
Der Sitzplatz im Satz
Dem Embedding fehlt noch etwas Einfacheres: wo das Token steht. „Hund beißt Mann“ und „Mann beißt Hund“ bestehen aus denselben drei Wörtern und holen dieselben drei Embeddings. Nur die Reihenfolge ist anders, und sie entscheidet, wer gebissen wird.
Die Blöcke mischen die Wörter ein, indem sie diese unterschiedlich stark zusammenzählen. Einer Summe ist die Reihenfolge aber egal: 2 + 3 ergibt dasselbe wie 3 + 2. Ohne Positionsangabe erfährt ein Token vor allem, welche Wörter es sieht; ihre Reihenfolge kann es höchstens näherungsweise erschließen. Deshalb gaben die Forschenden von 2017 die Position eigens mit.
GPT-2 löst das mit einer zweiten Tabelle, einer Zeile für jede der 1.024 Positionen im Kontextfenster (die Höchstzahl an Tokens, die das Modell auf einmal verarbeitet). Jede Zeile ist ein Embedding für einen Sitzplatz: Platz 1, Platz 2 und so weiter. Diese Zahlen starten zufällig und werden im Training gelernt.
Beide Embeddings sind gleich lang und werden Zahl für Zahl addiert. Mit nur einer Zahl: „Hund“ hat 0,2, der Sitzplatz 0,1, zusammen 0,3, und das geht in die Blöcke. Steht der Hund auf einem späteren Platz, etwa in „Mann beißt Hund“, ist der Sitzplatz-Wert negativ, und weniger geht hinein. Derselbe Hund ergibt auf einem anderen Platz eine andere Summe. Fachsprachlich heißt das Sitzplatz-Embedding Positions-Embedding.
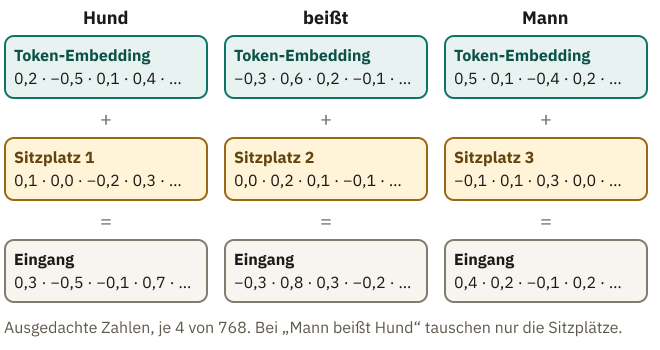
Geht dabei verloren, welches Token es war? Bei einer Zahl pro Vektor schon, denn verschiedene Paare ergeben dieselbe Summe. Bei Hunderten Zahlen kaum. An der kleinsten Version von GPT-2 wurde das nachgerechnet: In 99,8 Prozent der zufällig gezogenen Paare aus Token und Sitzplatz zeigte die Summe am ehesten in die Richtung des richtigen Tokens.
Bei GPT-2 ist die Summe der erste Zustand: Das Token weiß jetzt, wo es steht, aber nicht, welche Bank gemeint ist. Andere Modelle lösen den Platz anders. Wie kommt die Information der anderen Wörter hinein?
Der Scheinwerfer: Kontext gewichtet einmischen
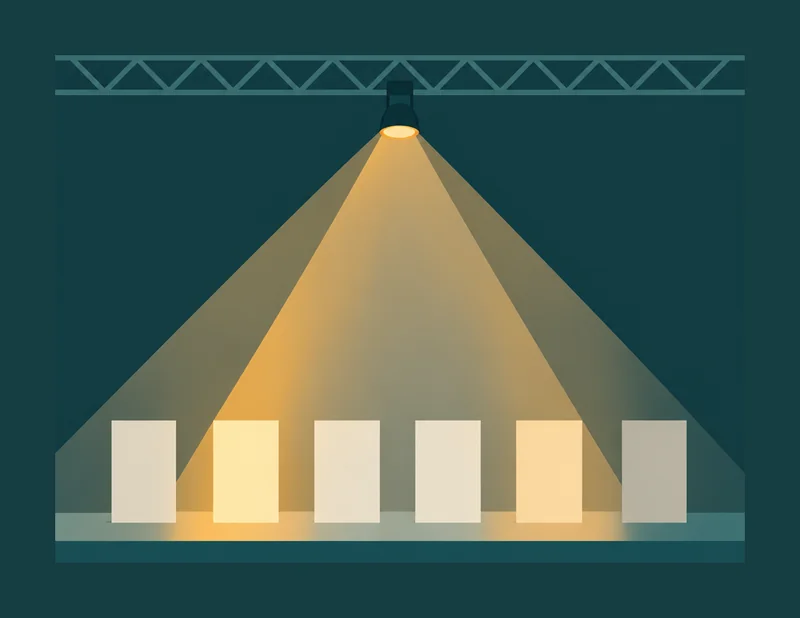
Für das Token, das gerade an der Reihe ist, gehen mehrere Scheinwerfer an. Ihr Licht verteilt sich auf die Tokens davor und auf das Token selbst. Was hell beleuchtet ist, fließt stark in den neuen Zustand ein, was im Halbdunkel liegt, nur wenig. Das Modell rechnet in Wirklichkeit alle Positionen gleichzeitig; hier wird nur eine herausgegriffen. Niemand stellt die Scheinwerfer von Hand ein: Das Modell rechnet selbst aus, wie hell jede Stelle wird. Dieses Verfahren heißt Attention, englisch für Aufmerksamkeit.
Angenommen, jeder Vektor hätte nur zwei Stellen, eine für „Sitzmöbel“ und eine für „Geld“ (ausgedachte Zahlen). Echte Vektoren haben Tausende Stellen ohne Namen. „Bank“ startet unentschieden bei (1 | 1). Der Scheinwerfer macht Hinweise auf Sitzmöbel hell. Welches Wort in „Ich sitze auf der Bank im Park“ dürfte er am hellsten beleuchten?
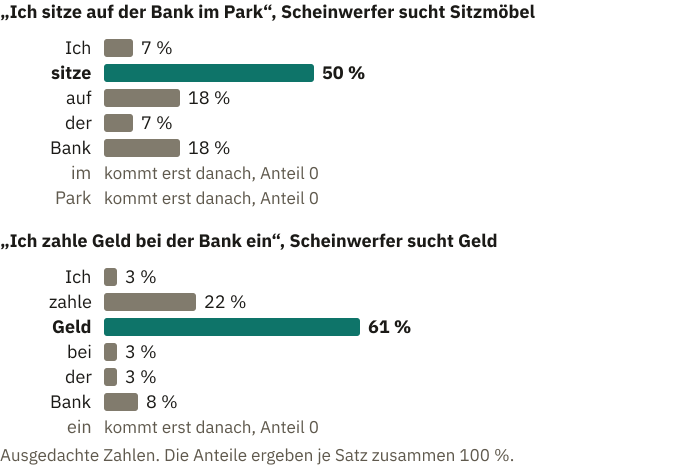
Am hellsten ist „sitze“ mit 50 Prozent, weil es den höchsten Score bekommt (2; wie der entsteht, zeigt der Abschnitt Query, Key und Value). „auf“ und „Bank“ liegen dahinter, „Ich“ und „der“ am weitesten zurück.
Die Regel kennst du aus dem Baustein über Wahrscheinlichkeit und Softmax: Softmax macht aus Punkten Anteile. Hier sind die Prozente Lichtanteile, keine Wahrscheinlichkeiten.
Jedes Wort gibt zwei Zahlen mit, eine pro Stelle:
| Wort | Anteil | gibt mit: Sitzmöbel | gibt mit: Geld |
|---|---|---|---|
| Ich | 7 % | 0 | 0 |
| sitze | 50 % | 2 | 0 |
| auf | 18 % | 0 | 0 |
| der | 7 % | 0 | 0 |
| Bank | 18 % | 1 | 1 |
Jeder Beitrag wird mit seinem Anteil malgenommen und alles zusammengezählt; das heißt gewichtete Summe. Sie wird zum alten Zustand addiert, statt ihn zu ersetzen.
Auf der Sitzmöbel-Stelle heißt das: Die Hälfte von „sitze“ mit seinem Wert 2 ergibt 1, dazu kommt ein kleiner Rest von „Bank“. Auf der Geld-Stelle trägt „Bank“ nur einen Bruchteil bei, und „sitze“ hat dort den Wert 0. So bleibt erhalten, was „Bank“ war: Die Sitzmöbel-Stelle wächst deutlich, die Geld-Stelle kaum.
Im Geld-Satz zeigt die Rechnung den Geld-Scheinwerfer. Dort hat „Geld“ den höchsten Score, „zahle“ den zweithöchsten. „Geld“ bekommt rund 61 Prozent des Lichts und zieht den Zustand Richtung Geld; „zahle“ und „Bank“ bekommen kleinere Anteile. „Ich“, „bei“ und „der“ teilen sich die restlichen 9 Prozent und geben nichts. „ein“ steht nach „Bank“ und bekommt deshalb nichts; warum, zeigt der Abschnitt Causal Mask.
Eine Ebene tiefer: Der Geld-Satz gerechnet
Die Scores sind ausgedacht: „Geld“ 3, „zahle“ 2, „Bank“ 1, die übrigen Wörter 0. Daraus werden Stärken: e³ ≈ 20 für „Geld“, rund 7,4 für „zahle“, rund 2,7 für „Bank“ und 1 für jedes der drei Wörter mit Score 0. Zusammen sind das rund 33. Die Anteile sind rund 61 Prozent für „Geld“, 22 für „zahle“, 8 für „Bank“.
Gemischt wird an der Geld-Stelle: „Geld“ mit seinem Value (0 | 2) liefert 0,61 · 2 ≈ 1,2, „zahle“ mit (0 | 1) liefert 0,22 · 1 ≈ 0,2, „Bank“ mit (1 | 1) liefert 0,08 · 1 ≈ 0,1. Zusammen ergibt das rund 1,5. An der Sitzmöbel-Stelle bleibt nur 0,08 von „Bank“. Die Mischung ist (0,08 | 1,5). Zum alten Zustand (1 | 1) addiert ergibt das (1,1 | 2,5).
Query, Key und Value: woher die Anteile kommen
Woher weiß der Scheinwerfer, dass „sitze“ besser passt als „der“? „Bank“ kommt wie bei einer Archivsuche mit einem Suchzettel: „Gibt es hier Hinweise auf Sitzmöbel?“ Jedes Wort davor ist ein Ordner: Etikett außen, Inhalt innen. Verglichen wird der Suchzettel mit den Etiketten, mitgenommen wird aus jedem Ordner umso mehr Inhalt, je besser sein Etikett passt.
Im Modell heißen die drei Teile Query (Suchzettel), Key (Etikett) und Value (Inhalt). Alle drei sind Vektoren aus dem Zustand eines Tokens: Die Query gehört zum aktuellen Token, Key und Value zu jedem sichtbaren Token.
Das Modell nimmt Query und Key Stelle für Stelle mal und addiert das Ergebnis. So entsteht ein Score für jedes sichtbare Token: ein Maß dafür, wie gut Query und Key zusammenpassen. Bei „sitze“ zählt nur die Sitzmöbel-Stelle, weil dort Query und Key beide etwas tragen; die Geld-Stelle bleibt bei beiden leer.
Die Query von „Bank“ sucht Sitzmöbel. Am besten passt „sitze“ mit dem Score 2; „auf“ und „Bank“ liegen mit 1 dahinter, „Ich“ und „der“ bekommen 0.
Aus den Scores macht Softmax die Anteile von eben. Im Beispiel wird jeder Score zu einer Stärke: Null Punkte ergeben die Stärke 1, und jeder Punkt mehr macht sie etwa 2,7-mal so groß. Die Stärken werden zu Anteilen, die 100 Prozent ergeben. So kommt „sitze“ mit den meisten Punkten auf 50 Prozent. Key und Value haben verschiedene Aufgaben: Woran ein Wort gefunden wird, muss nicht das sein, was es mitbringt. „auf“ passt mit seinem Key ein wenig, sein Value trägt aber nichts bei.
Live-Demo · zum Ausprobieren
Query trifft Key: Attention zum Nachrechnen
Ausgedachte SimulationAusgedachte, kleine Zahlen, damit du jeden Schritt im Kopf nachrechnen kannst. Jeder Vektor hat hier nur zwei Stellen: eine für Sitzmöbel, eine für Geld. Die Query von „Bank“ trifft auf die Keys der Wörter davor und auf den Key von „Bank“ selbst.
IchsitzeaufderBankimPark
Jeder Vektor: (Sitzmöbel | Geld). Gestrichelte Wörter stehen nach „Bank“ und bleiben gesperrt.
1 · Die Query von „Bank“
2 · Query trifft Key: Score und Anteil
Score = Stelle für Stelle malnehmen und addieren. Softmax macht aus den Scores Anteile.
3 · Values mischen und zum alten Zustand addieren
Probier es aus: Bleib im Park-Satz und stell die Query auf „sucht Geld-Hinweise“. Rate vorher: Welches Wort bekommt dann den größten Anteil, und ergeben die Anteile noch 100 %? Prüf danach dasselbe im Geld-Satz.
Auflösung
Im Park-Satz bekommt bei der Suche nach Geld-Hinweisen „Bank“ selbst den größten Anteil, 40 Prozent: Nur ihr Key (1 | 1) hat an der Geld-Stelle etwas, alle anderen Scores sind 0 und bekommen je 15 Prozent. Zusammen sind es wieder 100 Prozent, denn Softmax verteilt immer alles. Der neue Zustand (1,7 | 1,4) rückt nur wenig Richtung Geld: Den größten Anteil hat „Bank“ selbst: 40 Prozent seines Values (1 | 1) ergeben (0,4 | 0,4). „sitze“ bringt mit 15 Prozent seines Values (2 | 0) noch (0,3 | 0) dazu; die übrigen Wörter bringen nichts mit. Im Geld-Satz bekommt „Geld“ dagegen 61 Prozent, und der Zustand landet bei (1,1 | 2,5). Welches Wort viel Licht bekommt, hängt also von der Query ab, davon, wonach der Head sucht. In echten Modellen ist es genauso, nur mit Tausenden Stellen ohne Namen und gelernten Matrizen.
Alle Zahlen sind ausgedacht. Echte Vektoren haben Tausende Stellen ohne Namen, und ein echtes Modell teilt die Scores vor Softmax noch durch eine feste Zahl, die hier fehlt. Die beiden Query-Einstellungen stehen für zwei verschieden trainierte Query-Matrizen, etwa in zwei Heads. Anteile auf ganze Prozent gerundet, Mischung und Zustand auf eine Nachkommastelle.
Woher kommen Query, Key und Value? Wieder aus gewichteten Summen: Jede Zahl des Zustands wird mit einem Faktor malgenommen, und alles wird addiert. Für „Bank“ ergibt das auf der Sitzmöbel-Stelle einen Wert von 1, auf der Geld-Stelle 0; die Rechnung steht in der Box.
Die Faktoren stehen in einer Tabelle, einer Matrix, je eine für Query, Key und Value. Im Mischpult-Bild sind ihre Zahlen Regler, also Parameter: vom Training eingestellt und für jeden Text dieselben. Query, Key und Value sind Anzeigen, die für jeden Text neu entstehen.
Und „Park“, der beste Hinweis auf eine Sitzbank, bekam gar keinen Anteil. Warum?
Eine Ebene tiefer: Woher die Zahlen für „Bank“ kommen
Die Query von „Bank“ ist (1 | 0), der Key von „sitze“ ist (2 | 0). Query und Key werden Stelle für Stelle malgenommen und addiert: 1 · 2 + 0 · 0 = 2. Das ist der Score von „sitze“.
Echte Modelle teilen die Scores vorher noch durch eine feste Zahl, damit sie nicht zu groß werden; das Beispiel lässt das weg. Softmax macht daraus Stärken: Dafür wird jeder Score zur Potenz der Zahl e gerechnet, also mit etwa 2,72 als Grundzahl. Ein Score von 0 ergibt die Stärke 1, ein Score von 1 ergibt etwa 2,72, ein Score von 2 ergibt etwa 2,72 · 2,72 ≈ 7,4. Zusammen sind das rund 14,8, davon entfallen 7,4 auf „sitze“.
Die Query von „Bank“ entsteht ebenso: Aus (1 | 1) ergibt die Sitzmöbel-Stelle mit den Faktoren 0,5 und 0,5 den Wert 0,5 · 1 + 0,5 · 1 = 1, die Geld-Stelle mit Faktoren 0 den Wert 0.
Danach werden die Values gemischt. Für die Sitzmöbel-Stelle ergibt das 0,5 · 2 + 0,18 · 1 ≈ 1,2: 0,5 ist der Anteil von „sitze“ mit seinem Value 2, 0,18 der Anteil von „Bank“ mit seinem Value 1.
Nicht nach vorne schauen: die Causal Mask
„Park“ steht nach „Bank“. Sprachmodelle, die wie Chatbots von links nach rechts schreiben, haben eine feste Regel: Jede Position sieht nur sich selbst und die Positionen davor, nie die danach. Für „Bank“ ist „Park“ unsichtbar, obwohl es dasteht.
Der Grund liegt im Training: Dort wird der ganze Satz auf einmal verarbeitet, doch jede Position soll genau das nächste Token vorhersagen. Die Position von „Bank“ soll also „im“ vorhersagen. Könnte sie „im“ bereits sehen, müsste sie es nur abschreiben.
Eine Causal Mask setzt diese Regel um: Sie setzt den Score jeder späteren Position auf minus unendlich, bevor Softmax rechnet. Jeder Punkt weniger macht die Stärke kleiner; bei minus unendlich bleibt nichts übrig, der Anteil ist genau 0. Für einen ganzen Satz ergibt das ein Dreieck: Das erste Wort sieht nur sich, das letzte alle.
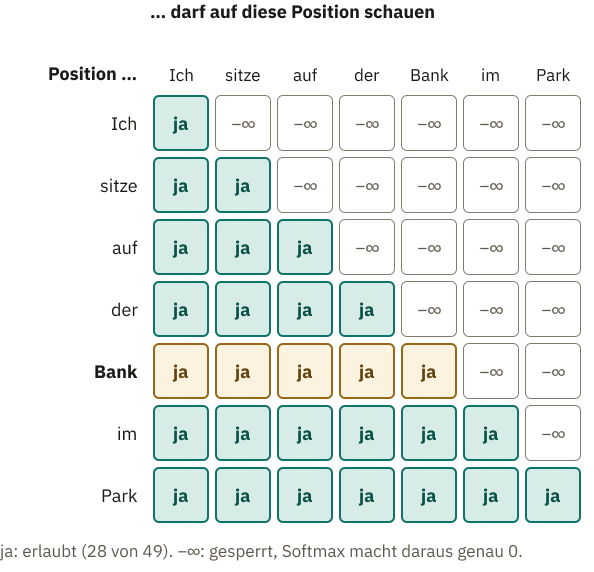
„Park“ dagegen darf auf alles schauen, auch zurück auf „Bank“. Das Modell sagt das nächste Wort aus dem Zustand der letzten Position voraus, und die sieht den ganzen Satz.
Viele Scheinwerfer, viele Blöcke
Ein einzelner Scheinwerfer müsste sein Licht zwischen Sitzmöbel und Geld teilen. Deshalb hat ein Block mehrere Scheinwerfer, Heads genannt, jeder mit eigener Query-Matrix. Ihre Mischungen werden hintereinander gelegt; eine gelernte Matrix bringt sie auf die übliche Länge, die zum Zustand addiert wird. Bei Qwen3-8B sind es 32 Heads pro Block, beim kleineren Qwen3-0.6B-Base 16. Manche lassen sich deuten: Ein Induction Head sucht, was nach dem letzten Auftreten des aktuellen Tokens folgte. Stand früher „Frau Kowalczyk“ im Chat und kommt jetzt „Frau“, hebt er „Kowalczyk“ hervor. Viele Heads zeigen kein solches Muster.
Live-Demo · zum Ausprobieren
Der Scheinwerfer im echten Modell
Echte Ausgabe, vorab berechnetHier leuchten die Scheinwerfer eines echten Sprachmodells. Tipp ein Token an: Die Tokens davor und das Token selbst leuchten so hell, wie groß ihr Anteil am Licht eines Heads ist. Was danach kommt, bleibt gesperrt.
Tokens des Satzes, antippen wählt das Token, das an der Reihe ist
␣ steht für ein Leerzeichen. Echte Tokens zerlegen manche Wörter.
So verteilt sich das Licht
„< 1 %“ heißt: weniger als ein Prozent. Solche Anteile sind zu klein für eine ganze Zahl; sie gehören zu den 100 %, ihr Wert steht nicht da.
Anteile werden geladen …
Probier es aus: Schau zuerst auf den Geld-Satz, der im Feld „Satz“ vorgewählt ist; nur er beantwortet diese Aufgabe, die anderen Sätze sind optional. Rate zuerst, welches Token im Geld-Satz in den meisten Heads den größten Anteil am Licht von „Bank“ bekommt. Stell dann Block und Head auf ein paar beliebige Werte und zähl jedes Mal die Prozentzahlen neben den Tokens zusammen. Vergleich die Summe am Ende mit 100 %. Wie oft welches Token in allen Heads vorn liegt, steht in der Auflösung. Erst danach zeigt „Deutlichster Head“ eine der seltenen Ausnahmen, in denen „Geld“ vorn liegt.
Auflösung
Die Rechenbeispiele im Abschnitt „Der Scheinwerfer“ nutzen ausgedachte Zahlen. Im Geld-Satz bekommt „Geld“ das meiste Licht. Im echten Modell ist das die Ausnahme: Im Geld-Satz ist „Geld“ nur in 9 der 448 Heads das Token mit dem größten Anteil am Licht von „Bank“; in 348 von 448 Heads liegt das Spezial-Token an der Textgrenze vorn. Das ist normal und kein Fehler der Demo: Forschende vermuten, dass ein Head, der nichts Passendes findet, sein Licht trotzdem verteilen muss, und dass das erste Token für jede spätere Position sichtbar ist. Jeder Head hat eine eigene gelernte Query-Matrix und damit eine eigene Query, deshalb leuchtet nicht überall dasselbe. Gleich bleibt nur: Softmax verteilt das Licht immer auf genau 100 Prozent der sichtbaren Tokens, und was nach „Bank“ kommt, bleibt gesperrt. Die Zahlen sind gerundet, und die Felder „< 1 %“ zählen beim Addieren nicht mit: Die ganzen Zahlen ergeben zusammen 100 minus den Anteil dieser Felder, auf eine ganze Zahl gerundet. Liegt die Summe darunter, steckt der Rest in diesen Feldern; das ist kein Fehler der Demo. Auch in größeren Modellen tritt das Muster auf, etwa bei Llama-2 mit 70 Milliarden Parametern. Das Licht allein erklärt keine Antwort.
Echte Anteile aus dem frei verfügbaren Modell Qwen3-0.6B-Base (28 Blöcke mit je 16 Heads), vorab berechnet und gerundet. Vor dem Satz ist hier das Spezial-Token <|endoftext|> gesetzt, das im Training die Texte voneinander trennt; ein neuer Text beginnt für dieses Modell also oft direkt dahinter. Es bedeutet nichts. Gezeigt werden nur die Anteile, nicht die Values. Der „deutlichste Head“ ist der, der vom markierten Token am meisten Licht auf ein bestimmtes Wort wirft. Er erklärt nicht, warum das Modell etwas antwortet.
Attention ist nur der erste Teil eines Blocks. Danach kommt eine Weiterverarbeitung (ein Feed-Forward-Netz, wie im Baustein über Schichten). Im Transformer-Paper von 2017 übernimmt eine ReLU diese Stufe; sie setzt negative Werte auf null. Ihr Ergebnis wird zum Zustand addiert. Attention plus Weiterverarbeitung bilden einen Transformerblock.
Eine Ebene tiefer: Welche Stufe nutzt Qwen3-8B, ein offenes Sprachmodell?
In der öffentlichen Konfigurationsdatei von Qwen3-8B steht unter hidden_act der Wert silu. Die Weiterverarbeitung nutzt aber eine Bauart namens SwiGLU: Eine Rechnung geht durch die Stufe silu, die andere bleibt linear, ihr Produkt geht weiter. Die Stufe silu ist eine abgerundete Kurve: Für große negative Eingaben geht sie gegen null, für große positive bleibt sie fast gleich der Eingabe, und dazwischen gibt es keine scharfe Ecke.
Im Modellcode geht die Ausgabe von gate_proj durch diese Stufe, wird mit der Ausgabe von up_proj multipliziert und dann durch down_proj geschickt.
Dieselbe Datei nennt unter num_hidden_layers die Zahl 36, die großen Blöcke aus diesem Baustein. Im Transformer von 2017 hatte jeder Head eigene Key- und Value-Matrizen. Um Speicher zu sparen, bilden die 32 Heads hier Vierergruppen, die sich Keys und Values teilen; nur die Querys sind verschieden.
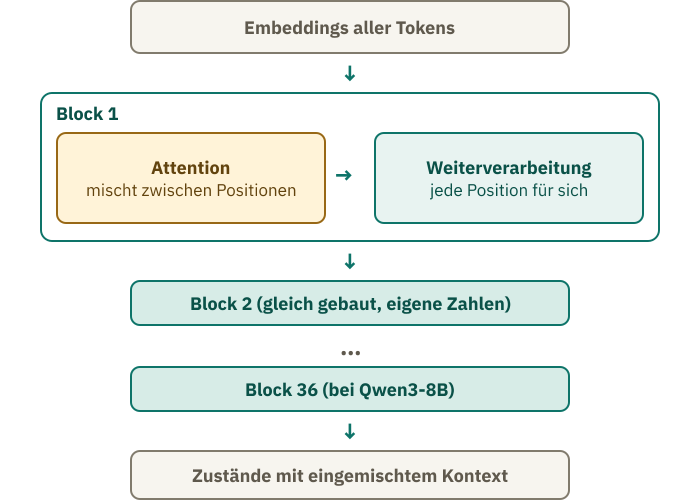
Kontext kommt nur über die Attention herein. In großen Modellen stecken trotzdem die meisten Parameter in der Weiterverarbeitung, bei Qwen3-8B rund zwei Drittel, nachgerechnet aus den veröffentlichten Werten. Vermutlich steckt dort Wissen. Je nach Modell stapeln sich viele Blöcke: die kleinste Version von GPT-2 hat 12, Qwen3-8B 36, das große GPT-3 96.
Kann man an den Scheinwerfern ablesen, warum der Chatbot so antwortet?
Was der Scheinwerfer nicht verrät
Manche Programme zeigen das Licht eines Heads als farbige Tabelle: Hier hat das Modell „hingeschaut“.
Wie wichtig ein Wort ist, lässt sich prüfen, indem man es weglässt. Eine viel zitierte Studie von 2019 machte diesen Test an älteren Modellen ohne Transformerblöcke: Wie stark sich die Vorhersage änderte, hing oft kaum mit den Anteilen zusammen. Andere Forschende halten dagegen: Solche Tests widerlegen nicht, dass die Anteile beim Erklären helfen können; es kommt darauf an, was man unter einer Erklärung versteht.
Über die Blöcke vermischt sich die Information immer stärker: Licht auf „sitze“ in Block 20 beleuchtet eine Mischung aus vielen Wörtern. Neben dem Anteil zählt der Value: Ein Token mit winzigem Value bringt wenig.
Außerdem landet auffällig viel Licht auf dem allerersten Token, auch wenn es wenig beiträgt. Forschende nennen das Attention Sinks. Sie vermuten: Die Anteile müssen 100 Prozent ergeben; findet ein Head nichts Passendes, muss das Licht irgendwohin, und das erste Token ist für jede spätere Position sichtbar. Im Versuch dieses Bausteins ist das erste Token ein Spezial-Zeichen an der Textgrenze, das Texte voneinander trennt. Auch Llama-2 mit 70 Milliarden Parametern zeigt das Muster.
Hier endet das Bild vom Scheinwerfer: Es zeigt gut, wie Information gemischt wird, erklärt aber nicht zuverlässig, warum eine Antwort entsteht.
„Bank“ startet mit demselben Token-Embedding und bei GPT-2 mit einem anderen Sitzplatz. In jedem Block mischt die Attention Values des Tokens selbst und früherer Tokens hinein, nie die späterer. Wie aus dem Zustand eine Score-Liste wird, zeigt der nächste Baustein.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.