Baustein 2 von 9 · Vom Modell zum AssistentenGelesen
Vom Textfortsetzer zum Assistenten: Was das Nachtraining aus einem Modell macht
Warum ein Grundmodell Fragen fortsetzt statt sie zu beantworten, was das Nachtraining ändert und woher ein Chatbot sein Datum und seine Vorgaben hat.
Gibst du einem Sprachmodell ohne Chat-Training eine Frage, schreibt es darunter oft weiter: noch eine Frage, noch eine Aufgabe, manchmal auch eine Antwort. Das klingt nach einem kaputten Programm. Tatsächlich macht das Modell genau das, wofür es trainiert wurde. Das Gespräch, das du heute führst, entsteht erst durch ein zweites Training, das aus diesem Modell einen Assistenten macht. Wie wird aus so einem Modell ein Gegenüber, das auf Fragen antwortet? Dieser Baustein zeigt es.
Ein Grundmodell schreibt weiter, es antwortet nicht verlässlich
Ein Grundmodell ist ein Modell nach dem Grundtraining, aber vor dem Chat-Training. Im Grundtraining hat es gelernt, das nächste Stück eines Textes vorherzusagen. Erinnerst du dich an den Baustein über Input und Output? Dort war jedes Stück Text das Ziel für den Text davor.
Ein Forschungspapier von OpenAI aus dem Jahr 2022 zeigt, was ein solches Modell mit einer Aufgabe macht. Die Autoren gaben GPT-3 mit 175 Milliarden Parametern diesen Auftrag, auf Französisch: „Schreib eine kurze Geschichte über einen Frosch, der in der Zeit bis ins antike Griechenland reist, auf Französisch.“ Im Paper steht die Aufgabe auf Französisch; die deutsche Fassung hier ist eine Übersetzung.
Was schreibt GPT-3 darauf? Sag es dir vorher. Das Paper zeigt in seiner Abbildung 8, was GPT-3 und seine nachtrainierte Variante InstructGPT tatsächlich geschrieben haben.
Wähle unten, welche der beiden Ausgaben GPT-3 geschrieben hat.
Live-Demo · zum Ausprobieren
Fortsetzen oder Antworten?
Ein Grundmodell bekommt einen Auftrag als Text und schreibt einfach weiter. Zwei Beispiele aus dem Paper zeigen, was dabei herauskommt. Rate zuerst: Welche Ausgabe hat GPT-3 geschrieben, das Grundmodell? Die andere stammt von InstructGPT, dem nachtrainierten Modell.
Welche der beiden Ausgaben hat GPT-3 geschrieben?
Écrivez une courte histoire sur une grenouille qui voyage dans le temps jusqu’à la Grèce antique en français.
Unsere Übersetzung: Schreib eine kurze Geschichte über einen Frosch, der in der Zeit bis ins antike Griechenland reist, auf Französisch.
Ausgabe A
Écrivez une histoire au sujet d’un enfant qui voudrait tout savoir sur les jeux des dieux et qui se retrouve dans l’une de leurs histoires.
Unsere Übersetzung: Schreib eine Geschichte über ein Kind, das alles über die Spiele der Götter wissen möchte und sich in einer ihrer Geschichten wiederfindet.
Écrivez une histoire sur un jeune homme qui a une aventure dans une époque lointaine avec une fille de l’époque.
Unsere Übersetzung: Schreib eine Geschichte über einen jungen Mann, der in einer fernen Zeit ein Abenteuer mit einem Mädchen aus dieser Zeit erlebt.
Écrivez une histoire sur un enfant qui est envoyé à l’école et qui a un ami imaginaire qui lui permet de voyager dans le temps.
Unsere Übersetzung: Schreib eine Geschichte über ein Kind, das in die Schule geschickt wird und einen imaginären Freund hat, der ihm erlaubt, durch die Zeit zu reisen.
Ausgabe B
La grenouille était perdue et épuisée. Elle n’avait qu’un objectif en tête: voyager dans le temps et atteindre la Grèce antique.
Unsere Übersetzung: Der Frosch war verloren und erschöpft. Er hatte nur ein Ziel im Kopf: durch die Zeit reisen und das antike Griechenland erreichen.
Premier problème, trouver un moyen de transport. Elle avait entendu dire que l’un des meilleurs moyens était de sauter dans une machine temporelle. Elle s’élança, et voilà qu’elle se retrouva dans le passé, au cours d’une nuit étoilée à l’odeur douce et envoûtante.
Unsere Übersetzung: Erstes Problem: ein Transportmittel finden. Er hatte gehört, eine der besten Möglichkeiten sei, in eine Zeitmaschine zu springen. Er sprang, und schon fand er sich in der Vergangenheit wieder, in einer sternklaren Nacht mit süßem, betörendem Duft.
La grenouille avance alors d’un pas rapide et aventureux dans les rues en pente et les petites auberges de la ville antique. [...]
Unsere Übersetzung: Der Frosch machte sich nun mit raschen, abenteuerlustigen Schritten auf den Weg durch die abschüssigen Gassen und kleinen Herbergen der antiken Stadt. [...]
What is the purpose of the list C in the code below?
def binomial_coefficient(n, r):
    C = [0 for i in range(r + 1)];
    C[0] = 1;
    for i in range(1, n + 1):
        j = min(i, r);
        while j > 0:
            C[j] += C[j - 1];
            j -= 1;
    return C[r]
Unsere Übersetzung: Was ist der Zweck der Liste C im folgenden Code?
Ausgabe A
The list C in this code is used to store the values of the binomial coefficient as the function iterates through the values of n and r. It is used to calculate the value of the binomial coefficient for a given value of n and r, and stores the result in the final return value of the function.
Unsere Übersetzung: Die Liste C wird in diesem Code verwendet, um die Werte des Binomialkoeffizienten zu speichern, während die Funktion die Werte von n und r durchläuft. Sie dient dazu, den Wert des Binomialkoeffizienten für ein gegebenes n und r zu berechnen, und speichert das Ergebnis im Rückgabewert der Funktion.
Ausgabe B
A. to store the value of C[0]
Unsere Übersetzung: A. um den Wert von C[0] zu speichern
B. to store the value of C[1]
Unsere Übersetzung: B. um den Wert von C[1] zu speichern
C. to store the value of C[i]
Unsere Übersetzung: C. um den Wert von C[i] zu speichern
D. to store the value of C[i - 1]
Unsere Übersetzung: D. um den Wert von C[i - 1] zu speichern
Auflösung
GPT-3 setzt die Aufgabenliste fort: Es schreibt weitere Aufgaben derselben Art, statt die Geschichte zu erzählen. Bei der Code-Frage setzt es vier Antwortmöglichkeiten „A. bis D.“ an, wie bei einer Multiple-Choice-Aufgabe, und beantwortet die Frage in diesem Beispiel nicht. Der Grund liegt im Trainingsziel: Das Modell hat gelernt, das nächste Stück Text vorherzusagen, und auf eine Aufgabe folgt in solchen Texten oft eine weitere. InstructGPT antwortet dagegen; die Legende vermerkt aber, dass seine Antwort auf die Code-Frage nicht ganz richtig ist. Laut Legende beantwortete GPT-3 die Code-Frage nur in etwa der Hälfte der Fälle.
Quelle: Ouyang et al. 2022, InstructGPT (arXiv:2203.02155), Abbildung 8, S. 15. Verglichen werden GPT-3 mit 175 Milliarden Parametern (das Grundmodell) und InstructGPT 175B. Die Ausgaben sind Abdrucke aus dem Paper; hier läuft kein Modell neu. Die Prompts hat das Paper laut Bildlegende ausgesucht, die Ausgaben nicht. Die Übersetzungen sind unsere; die Originale stehen jeweils darüber.
Die Demo zeigt die Ausgaben aus der Abbildung im Paper; sie wurden nicht neu erzeugt.
Im Paper steht die französische Aufgabe, eine kurze Geschichte über einen Frosch zu schreiben, der in das antike Griechenland reist. GPT-3 schreibt darauf keine Geschichte, sondern drei weitere Aufgaben derselben Art (Ouyang et al. 2022, arXiv:2203.02155v1, Abbildung 8, S. 15).
Das liegt an der Trainingsaufgabe: den nächsten Textteil vorhersagen. Für die Vorhersage ist ein Auftrag nur eine Textstelle wie jede andere. In solchen Texten folgt auf einen Auftrag oft der nächste. Das Paper stellt diese Vorhersageaufgabe dem Ziel gegenüber, den Anweisungen des Nutzers hilfreich und sicher zu folgen. Die Autoren nennen die Vorhersageaufgabe deshalb „misaligned“, auf Deutsch etwa nicht auf die Anweisungen ausgerichtet.
Eine Schreibkraft schreibt jedes angefangene Dokument weiter, ohne zu wissen, wer es liest. Bekommt sie ein Blatt mit einer Aufgabenliste, schreibt sie oft weitere Aufgaben darunter. Das ist kein Versagen, sie folgt dem Muster, das in solchen Dokumenten üblich ist. Das Blatt ist die Eingabe. Die Gewohnheiten der Schreibkraft (die Gewichte) und ihr nächster Satz (die Vorhersage) zeigt das Bild nicht; der Text ordnet sie zu.
Die Grenze dieses Bildes: Die Schreibkraft hat keine Absicht. Ein Modell wählt kein Ziel. Es setzt Muster fort, die im Training häufig waren.
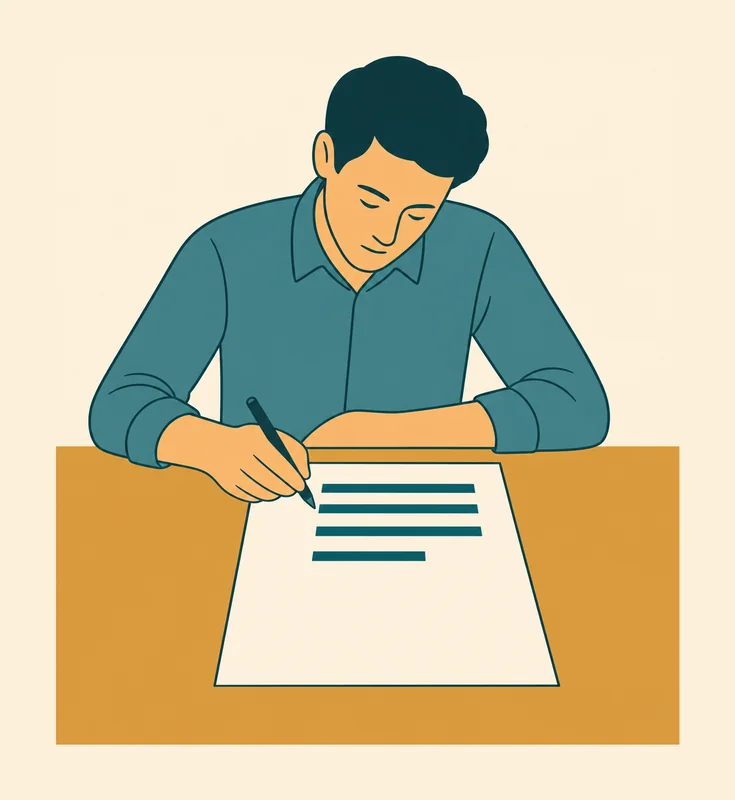
Das Muster ist dasselbe, ob der Text wie ein Auftrag aussieht oder wie eine Frage: Das Modell setzt fort, was in Texten dieser Art üblicherweise folgt. Auch bei Fragen, die nicht nach Aufgaben aussehen, zeigt sich das. Im Paper steht eine Code-Frage: Was bewirkt die Liste C in diesem Programm? Auf die Code-Frage setzt GPT-3 vier Antwortmöglichkeiten „A. bis D.“ an, wie bei einer Multiple-Choice-Aufgabe (ebenda). Laut Legende beantwortet GPT-3 die Code-Frage nur in etwa der Hälfte der Fälle; auch bei derselben Frage kommt also mal eine Antwort, mal etwas anderes heraus. Im Paper steht in der Bildunterschrift: Die Autoren haben die Beispiele ausgewählt, um bestimmte Verhaltensweisen zu zeigen. Die Ausgaben selbst haben sie nicht ausgewählt.
Dass moderne Modelle trotzdem Fragen beantworten, liegt an einem zweiten Training, dem Nachtraining.
Drei Schritte, die aus Fortsetzern Helfer machen
Was läuft beim Nachtraining anders als beim Grundtraining, und was bleibt gleich? Das Nachtraining folgt auf das Grundtraining. Aus dem Baustein über Input und Output kennst du seinen Zweck: Der Chatbot soll lernen, auf Fragen zu antworten. Das Ergebnis heißt Instruktionsmodell, weil es Anweisungen befolgen soll.
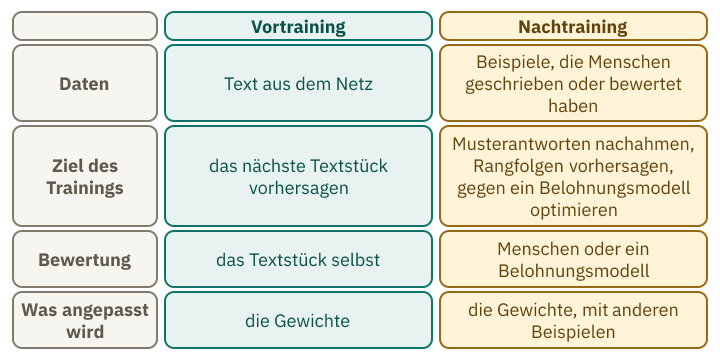
Das Paper InstructGPT beschreibt sein Verfahren in drei Schritten. Im ersten sammelt man Beispiele für gute Antworten und trainiert damit das Modell weiter. Ein Team von rund vierzig Auftragskräften erstellte diese Musterantworten. Dafür nutzte es rund 13.000 Prompts, also Aufgaben oder Fragen.
Im zweiten Schritt bekommen Auftragskräfte mehrere Antworten auf dieselbe Frage und ordnen sie danach, wie hilfreich sie sind. Anhand dieser Rangfolgen lernt ein Belohnungsmodell vorherzusagen, welche Antwort ein Mensch bevorzugen würde. Auch dieses Modell muss also trainiert werden, bevor es Antworten bewerten kann. Auch für das Belohnungsmodell brauchte es Zehntausende Prompts.
Im dritten Schritt antwortet das Modell auf neue Prompts, das Belohnungsmodell bewertet jede Antwort mit einer Zahl, und die Gewichte des Modells werden so angepasst, dass hoch bewertete Antworten wahrscheinlicher werden. Für diesen Schritt nutzte es ebenfalls Zehntausende Prompts, die Kunden über die Programmierschnittstelle geschickt hatten.
Auch im Nachtraining werden die Gewichte des Modells angepasst. Was sich ändert, sind die Beispiele und die Bewertung. Im Grundtraining war die Aufgabe, das nächste Textstück vorherzusagen. Wie weit seine Vorhersage vom tatsächlichen Textstück abwich, bestimmte die Anpassung der Gewichte. Im Nachtraining dienen Musterantworten und Rangfolgen als Grundlage.
Die Schreibkraft bekommt nun Musterantworten und lernt, welche Entwürfe Auftragskräfte bevorzugen. Das Bild hat eine Grenze: Beim Training liest keine Person jede neue Antwort und bewertet sie sofort. Diese Bewertung übernimmt das Belohnungsmodell. Es hat aus den zuvor gesammelten Rangfolgen gelernt, menschliche Urteile nachzuahmen.
Die Animation zeigt die drei Schritte nacheinander. Der Text oben beschreibt sie vollständig.
Eine Ebene tiefer: Was das Nachtraining kostet
Wie viel Rechenaufwand steckt im Nachtraining? Das Paper gibt dazu Werte in Petaflop/s-Tagen an, einer Einheit für Rechenaufwand. Das Paper nennt Werte für zwei Trainingsläufe: das überwachte Nachtraining (4,9 Petaflop/s-Tage) und den PPO-Schritt mit Vortraining-Updates (60). Das Belohnungsmodell ist darin nicht beziffert. Das Grundtraining von GPT-3 brauchte 3.640. Eigene Rechnung: 4,9 geteilt durch 3.640 sind rund 0,13 Prozent, 60 geteilt durch 3.640 rund 1,6 Prozent. Die Werte gelten für das Modell von 2022.
Der Optimierungsschritt heißt PPO, kurz für Proximal Policy Optimization, ein Verfahren aus dem Verstärkungslernen. Es ändert die Gewichte schrittweise. Für jedes Wort der Antwort wird eine Strafe abgezogen, die umso größer ist, je stärker die Antwort von der Ausgangsfassung (dem Modell nach Schritt 1) abweicht. Diese Strafe soll verhindern, dass das Modell die Bewertung mit Antworten ausnutzt, die dem Belohnungsmodell gefallen, Menschen aber nicht.
Ein kleineres Modell gewinnt gegen das große
Der deutlichste Beleg für die Wirkung des Nachtrainings kommt aus einem Vergleich. Auftragskräfte bewerteten die Antworten von InstructGPT mit 1,3 Milliarden Parametern und die Antworten von GPT-3 mit 175 Milliarden Parametern. Die kleinere Version wurde bevorzugt. Das Paper spricht von über hundertmal weniger Parametern.
Der Vergleich hat eine Grenze. Die Auftragskräfte bewerteten die Antworten anhand von Anfragen, die Kunden über die Programmierschnittstelle (API) an das Modell geschickt hatten und die nicht ins Training eingegangen waren. Das zeigt, welche Antworten sie in diesem Test bevorzugten. Es bedeutet nicht, dass das kleinere Modell in jeder Hinsicht besser ist. Außerdem hat das Nachtraining einen Preis. Auf mehreren öffentlichen Testdatensätzen wurde die Leistung schlechter, die Autoren nennen das „alignment tax“, eine Steuer auf die Anpassung. Eine Zwischenlösung, die das Training zusätzlich mit Texten aus dem Grundtraining mischte, milderte das, beseitigte es aber nicht. Bei Übersetzungen und bei Leseverständnis-Aufgaben blieb das Modell mit Vortraining-Updates hinter GPT-3 zurück.
Die Ergebnisse stammen aus dem Jahr 2022. Der Vergleich zeigt eine Tendenz für dieses Modell und seine Tests, keine allgemeine Eigenschaft von Modellen.
Was das Nachtraining formt: eine offene Hypothese
Was lernt das Modell im Nachtraining wirklich? Eine Hypothese aus dem Jahr 2023 heißt Superficial Alignment Hypothesis, auf Deutsch etwa „Hypothese der oberflächlichen Anpassung“. Nach dieser Hypothese entstehen Wissen und Fähigkeiten eines Modells fast vollständig im Grundtraining. Das Nachtraining, im Paper „Alignment“ genannt, bringt dem Modell bei, welche Art von Antwort zur jeweiligen Situation im Gespräch mit Nutzern passt.
Die Hypothese stützt sich auf ein kleines Experiment mit 1.000 handverlesenen Beispielen. Bei so wenigen Beispielen lässt sich das Ergebnis nur begrenzt verallgemeinern.
2024 hat eine Gruppe von Forschenden die Hypothese geprüft. In ihrer Zusammenfassung steht, dass die Leistung nach dem Nachtraining mit der Zahl der Beispiele wächst. Bei Aufgaben wie Mathematik verändern wenige Beispiele vor allem den Stil. Für die bestmögliche Leistung reichen wenige Beispiele nicht aus. Das spricht gegen die Lesart, Nachtraining verändere nur den Stil, widerlegt die Hypothese aber nicht.
Dass Nachtraining nur den Stil verändert, ist eine Hypothese, kein gesicherter Befund. Ob das Modell dabei neues Wissen erwirbt, lässt sich aus dem Befund von 2024 nicht ablesen.
Der Chat ist Text mit Marken
Woher erkennt ein Modell, wer im Chat spricht? Die Modellkarte des Grundmodells Qwen2.5-7B von Alibaba rät davon ab, Grundmodelle für Gespräche zu nutzen. Dort steht die Empfehlung, das Modell mit Nachtraining weiter anzupassen. Damit das Modell erkennt, wer im Chat spricht, bekommt der Text eine feste Form, die jede Nachricht mit ihrer Rolle markiert.
Diese Form legt die Chat-Vorlage fest. Sie nimmt die Nachrichten mit ihren Rollen und setzt daraus eine einzige Folge von Tokens. Jede Nachricht bekommt Marken, Spezial-Tokens, die sagen, wer spricht und wo der Beitrag endet. Die Vorlage von Qwen3-0.6B setzt etwa <|im_start|>user vor deine Frage und <|im_end|> an ihr Ende. Zum Schluss fügt sie <|im_start|>assistant ein. Dieser „offene Kopf“ markiert den Beginn der Antwort, die das Modell schreiben soll. Fehlt er, endet die Folge mit deiner Nachricht, und das Modell kann an deiner Nachricht weiterschreiben, statt ihr zu antworten.
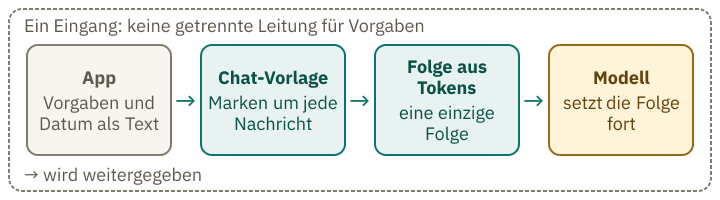
Die Dokumentation fasst das so zusammen: Der Chat ist also nur eine Folge von Tokens. Mit den falschen Marken arbeiten Modelle deutlich schlechter.
Live-Demo · zum Ausprobieren
Der offene Kopf am Ende der Folge
Ein Chatmodell bekommt keine Liste von Nachrichten, sondern eine einzige Textfolge mit Marken. Die Chat-Vorlage baut sie aus deinen Nachrichten. Ändere Systemnachricht und Nachricht. Sag zuerst voraus, wie die Folge ohne Antwortbeginn endet. Öffne dann die Folge bei ausgeschaltetem Schalter und schalte den Antwortbeginn danach ein, um den Unterschied zu sehen.
Wie endet die Folge, wenn der Antwortbeginn fehlt?
Folge zeigen (erst vorhersagen)
Die Folge, die das Modell bekommt
Die Marken sind hervorgehoben: die Spezial-Tokens und die Rollennamen.
Auflösung
Ohne offenen Kopf endet die Folge mit deiner Nachricht und ihrer Endmarke. Das Modell kann die Folge fortsetzen, statt zu antworten: Es schreibt an deiner Nachricht weiter, wie die Hugging-Face-Doku es beschreibt („continuing the user’s message instead of replying to it“). Mit dem Schalter steht am Ende `<|im_start|>assistant` und ein Zeilenumbruch. Dieser offene Kopf sagt dem Modell, dass jetzt die Antwort des Assistenten beginnt. Die Vorlage von Qwen3 setzt nur dann einen Systemblock ein, wenn du eine Systemnachricht eingibst; einen Standardtext gibt es nicht.
Live im Browser. Die Regeln der veröffentlichten Chat-Vorlage von Qwen3-0.6B (tokenizer_config.json, Abruf 2026-10-12) sind nachgebaut und in den Tests gegen das Original geprüft. Kein Modell rechnet hier. Die Demo zeigt Text, keine Token-IDs; die Tokenisierung ist nicht Teil davon. Das Beispiel-Chat ist ausgedacht, die Vorlage ist echt.
Die Demo bildet die Textfolge nach den Regeln der veröffentlichten Qwen3-Vorlage. Dabei läuft kein Modell. Du siehst nur den Text, den es erhalten würde.
Die Systemanweisung der App ist ebenfalls nur ein Eintrag in dieser Folge, meist ganz vorn. Bei Qwen3 fehlt ohne Systemanweisung dieser Eintrag ganz; die Vorlage setzt dafür keinen Ersatztext ein.
Die gpt-oss-Modelle von OpenAI verwenden ein anderes Format: Harmony. Die Anweisungen an das Modell stehen in einer eigenen Nachrichtenrolle, der Entwicklernachricht (developer). Sie entspricht der Systemanweisung in anderen Formaten. Die Grundidee ist dieselbe: Alles, was das Modell sieht, ist Text in einer Folge. Die Beispiele dazu stehen im Baustein über Tokenisierung im Modell.
Das Datum steht im Text, nicht im Modell
Fragst du einen Chatbot nach dem heutigen Datum, bekommst du oft eine richtige Antwort. Woher weiß er das? Das Grundtraining endet an einem Stichtag; was danach geschah, konnte es nicht lernen. Ein aktuelles Datum kann das Modell nicht aus dem Training haben. Es kommt meist als zusätzlicher Text an, den das Modell vor seiner Antwort erhält.
Das Unternehmen hinter dem Chatbot Claude (Anthropic) beschreibt in seinen Versionshinweisen, dass die Systemanweisungen der eigenen Apps dem Modell zu Beginn jedes Gesprächs Angaben wie das aktuelle Datum geben. Die Vorgaben gelten ausdrücklich nicht für die Programmierschnittstelle (API), über die ein eigenes Programm das Modell anspricht. Wer so ein Modell nutzt, muss das Datum selbst mitschicken, wenn es im Input stehen soll.
Wenn du wissen möchtest, woher ein Chatbot sein Datum hat, schau zuerst auf den Text, den er vor seiner Antwort erhält. Auch das Beispiel zum Harmony-Format trägt Wissensstand und Datum, und zwar in einer eigenen Systemnachricht neben der Entwicklernachricht. Das sind Beispielwerte aus der Dokumentation, keine Angaben zu einem bestimmten Modell. Entscheidend ist der Ort: Die Zeile steht im Text, sie ist kein Wissen, das das Modell mitbringt. Die Qwen3-Vorlage fügt kein Datum ein. Soll das Modell eines erhalten, muss die App es hinzufügen.
Die Folgerung: Ein Datum kommt von der App, aus einer Nachricht, die du selbst schreibst, oder die Vorlage setzt eines ein. Manche Vorlagen, etwa die aus dem Baustein Tokenisierung im Modell, setzen ein festes Standarddatum ein, wenn die App keines mitgibt. Ein festes Datum aus der Vorlage passt nur zufällig zum heutigen Tag. Ob ein Datum stimmt, hängt also davon ab, was die App mitschickt.
Was am Ende bleibt
Die Frage vom Anfang lässt sich jetzt beantworten. Ein Grundmodell hat gelernt, Text fortzusetzen. Ein Auftrag ist dabei eine Textstelle wie jede andere. Deshalb beantwortet es Fragen nicht verlässlich. Das Nachtraining bringt ihm bei, welche Fortsetzungen Menschen bevorzugen. Im beschriebenen Verfahren (InstructGPT) geschieht das durch ein weiteres Training mit anderen Beispielen und einer anderen Bewertung.
Der Assistent sieht im Chat nur eine einzige Folge: Vorgaben, Datum, die bisherigen Nachrichten und die neue Frage, alles als Text mit Marken. Was er an Wissen mitbringt, stammt nach der Hypothese vor allem aus dem Grundtraining; das Nachtraining formt, wie es sich zeigt.
Im nächsten Baustein fragst du, was zwischen Frage und Antwort passiert, wenn ein Modell vorher länger „nachdenkt“.
Übung · erst selbst lösen
Welche Ausgabe stammt von welchem Modell?
Dieselbe Eingabe, zwei Ausgaben. Die Beispiele sind für diese Übung ausgedacht.
Eingabe: „Schreib drei Städte in Frankreich auf.“
Ausgabe A: „Schreib drei Städte in Deutschland auf. Schreib drei Flüsse in Europa auf.“
Ausgabe B: „Gern: Paris, Lyon und Marseille sind drei große Städte in Frankreich.“
Welche Ausgabe stammt vom Grundmodell, welche vom Assistenten? Begründe deine Zuordnung mit dem Trainingsziel und dem Nachtraining.
Auflösung anzeigen
Ausgabe A stammt vom Grundmodell. Sein Trainingsziel ist das nächste Stück Text. Bei diesem Auftrag ist die naheliegende Fortsetzung eine weitere Aufgabe, deshalb setzt es die Aufgabenliste fort. Ausgabe B stammt vom Assistenten: Sie antwortet im Chat-Ton („Gern:“). Das Grundmodell antwortet manchmal auch, deshalb ist die Antwort allein kein Beweis; den Ton hat das Nachtraining mit Musterantworten und Bewertungen geformt. Das Nachtraining ändert vor allem die Beispiele und die Bewertung. Das Grundmodell ist die Basis dafür.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.