Baustein 4 von 6 · Der Weg durchs ModellGelesen
Embeddings: wie aus einer Nummer ein gelernter Vektor wird
Warum eine Token-ID nichts über Ähnlichkeit verrät, wie im Training aus Zufallszahlen ähnliche Steckbriefe für ähnlich verwendete Tokens werden und was ein großes Vokabular kostet.
An der Supermarktkasse verrät der Barcode genau eine Sache: welcher Artikel es ist. Dass Äpfel und Pfirsiche beide Obst sind, steht in keinem Strichcode. So geht es einem Sprachmodell mit deiner Chatnachricht. Nach dem vorigen Baustein ist sie eine Folge von Token-IDs, und jede ID sagt nur, welches Textstück gemeint ist.
Die kleinste Version des frei verfügbaren Modells GPT-2 hat ein englisches Vokabular (die feste Liste aller Stücke, die ein Tokenizer kennt). Wenn hier von GPT-2 die Rede ist, ist immer diese Version gemeint. Mitten im Satz, mit Leerzeichen davor, trägt „apple“ die Nummer 17180, „laptop“ die 13224 und „peach“, der Pfirsich, die 47565. Der Nummer nach liegt der Laptop viel näher am Apfel als der Pfirsich. Behandelt das Modell deshalb Apfel und Laptop als verwandt?
Was einer Nummer fehlt
Eine Token-ID ist die Nummer auf einer Karteikarte, wie im Baustein über Token-IDs. Sie sagt, welches Textstück gemeint ist, und bedeutet selbst nichts. Vergeben hat die Nummern der Tokenizer, als er sein Vokabular aufgebaut hat, ohne Blick auf die Bedeutung. Benachbarte Nummern stehen deshalb nicht für ähnliche Stücke.
Auf der Karteikarte des Tokenizers steht zu der Nummer nur das Textstück. Das Modell benutzt dieselbe Nummer als Seitenzahl in seinem eigenen dicken Nachschlagebuch. Das kennst du aus dem Baustein über Skalar, Vektor, Matrix und Tensor. Auf jeder Seite stehen bei GPT-2 768 Zahlen. Im Rechner ist das eine Zeile einer großen Tabelle; die Token-ID ist ihre Zeilennummer. Das Modell schlägt also die Zahlen des Tokens nach, keinen Fakt wie „Frankreich | Paris“.
Diese Zeile heißt hier der Steckbrief des Tokens: eine feste Folge von Zahlen, die zu genau diesem Token gehört.
Anders als Nummern lassen sich Steckbriefe vergleichen. Ein ausgedachtes Beispiel mit nur zwei Stellen, die zum Mitdenken Namen bekommen: „wächst am Baum“ und „hat einen Akku“. Der Apfel ist bei „wächst am Baum“ stark und bei „hat einen Akku“ schwach, der Pfirsich fast genauso, der Laptop umgekehrt. Die Zahlen zeigt die Skizze unten. Echte Steckbriefe haben 768 Stellen, und keine davon trägt einen Namen.
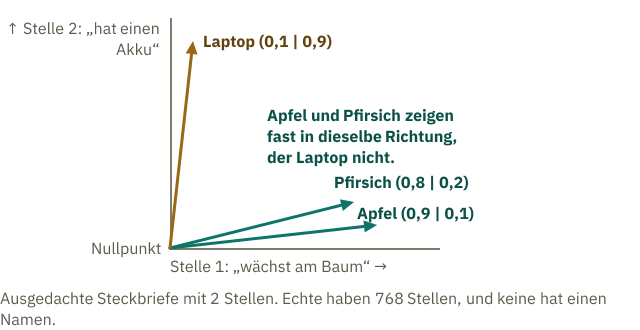
Trägt man die erste Zahl nach rechts und die zweite nach oben ab, wird jeder Steckbrief zu einem Pfeil vom Nullpunkt aus. Verglichen wird die Richtung der Pfeile, auch bei 768 Stellen, die niemand mehr zeichnen kann. Zeigen zwei Steckbriefe in eine ähnliche Richtung, heißen sie Nachbarn.
In der Skizze zeigen die Pfeile von Apfel und Pfirsich fast in dieselbe Richtung, der des Laptops in eine ganz andere.
Wie aus Zufallszahlen Steckbriefe werden
Wer hat die Zahlen so eingetragen? Niemand. Vor dem Training stehen in der Tabelle Zufallszahlen. Jedes Token startet mit einem anderen Steckbrief. Üblich sind kleine Werte, zufällig um null gestreut. In diesem Zustand hat „apple“ mit „peach“ nicht mehr gemeinsam als mit „laptop“.
Dann beginnt das Training, wie im Baustein über Parameter, Training und Benutzen: Das Modell sagt das nächste Token vorher, und seine Parameter, die Regler am Mischpult, werden ein Stück nachgestellt, damit die Vorhersage besser passt. Auch die Zahlen in der Tabelle sind solche Regler. Kommt ein Token in einem Trainingssatz vor, wird deshalb auch seine Zeile nachgestellt.
Angenommen, ein kleines Modell hat für „Apfel“ und „Pfirsich“ je eine eigene Zeile. In seinen Trainingstexten stehen Sätze wie „Der Apfel ist reif.“ und „Der Pfirsich ist reif.“ Nach „Apfel“ soll das Modell „ist“ vorhersagen, also wird die Zeile „Apfel“ so verstellt, dass „ist“ besser passt. Nach „Pfirsich“ folgt dasselbe. „Laptop“ steht dagegen in Sätzen wie „Der Laptop hat einen Akku.“
Warum werden die beiden Zeilen dabei einander ähnlich? Nach der Tabelle folgt für jedes Token dieselbe Rechnung mit denselben Reglern. In einem ausgedachten Spielzeugmodell hat jeder Steckbrief nur eine Zahl. Die Rechnung danach ist „mal 2“, und heraus kommt der Score (eine Bewertung, wie gut ein Textstück passt) für „ist“ als nächstes Token. Für dieses Beispiel ist als Ziel ein Score von genau 10 gewählt. Zu viel ist hier so falsch wie zu wenig. Echte Scores zählen nur im Vergleich zu den anderen.
In der Zeile „Apfel“ steht anfangs eine kleine Zahl, ihr Score ist also zu klein. Weil fünf mal zwei zehn ergibt, wird die Zahl Schritt für Schritt Richtung fünf nachgestellt. In der Zeile „Pfirsich“ steht eine zu große Zahl; auch sie wandert Richtung fünf. Beide landen bei fünf, weil dieselbe Rechnung dasselbe Ergebnis liefern soll.
Nach „Laptop“ folgt dagegen „hat“. Dort soll der Score für „ist“ niedrig sein, also wandert die Zahl in der Zeile „Laptop“ nach unten, weg von der Fünf. In echten Modellen ist die Rechnung nach der Tabelle viel länger, und auch ihre Regler werden im Training nachgestellt. Auch dort gilt: Tokens, nach denen Ähnliches folgt, werden ähnlich nachgestellt. Bei vielen Zahlen pro Zeile heißt das: Ihre Pfeile zeigen in ähnliche Richtungen.
Sprachwissenschaftler hatten die Idee dahinter schon in den 1950er-Jahren: Wörter, die in ähnlichen Umgebungen vorkommen, haben meist ähnliche Bedeutungen. Sie heißt Verteilungshypothese. Der Linguist J. R. Firth fasste sie 1957 so zusammen: „You shall know a word by the company it keeps“, sinngemäß: Ein Wort erkennt man an den Wörtern, mit denen es oft zusammensteht.
Live-Demo · zum Ausprobieren
Aus Zufall werden Steckbriefe
Ausgedachte SimulationJedes Wort aus 42 kurzen Sätzen hat einen Steckbrief aus nur zwei Zahlen, hier als Punkt gezeichnet. Am Anfang sind die Zahlen zufällig. Jeder Trainingsschritt nimmt einen Satz, lässt jedes Wort die zwei Wörter danach vorhersagen und stellt die benutzten Zeilen ein Stück nach. Jeder Punkt ist die Spitze eines Pfeils vom Nullpunkt wie in der Skizze; zur Vereinfachung misst die Demo den Abstand der Punkte, nicht die Richtung.
Das erfundene Wort „Quabbe“, der Stern, steht nur in zwei Sätzen: „Die Quabbe ist reif.“ und „Die Quabbe hängt am Baum.“ Vermute, neben welchem Wort sein Punkt am Ende landet. Dann starte das Training.
- Obst
- Tiere
- Geräte
- Tätigkeiten
- Rätselwort
| Wort | Zahl 1 | Zahl 2 | Letzter Satz |
|---|---|---|---|
| Apfel | |||
| Pfirsich | |||
| Hund | |||
| Katze | |||
| Laptop | |||
| Handy | |||
| essen | |||
| schälen | |||
| streicheln | |||
| füttern | |||
| laden | |||
| bellt | |||
| Quabbe |
0
Auflösung
„Quabbe“ landet bei „Apfel“ und „Pfirsich“. In den beiden Quabbe-Sätzen folgt auf das Wort dasselbe wie auf Apfel und Pfirsich: „ist reif“, „hängt am Baum“. Jeder Trainingsschritt stellt seine Zeile deshalb so nach wie die Zeilen der Obstwörter, und die Punkte rücken zusammen. Was eine Quabbe ist, stand nirgends; die Gruppen und Farben vergibt nur die Demo. Echte Modelle lernen ihre Tabelle auf dieselbe Weise, nur mit Milliarden Sätzen und Hunderten Zahlen pro Zeile.
Eine echte Rechnung im Kleinformat: 42 ausgedachte Sätze statt Milliarden Texten, 2 Zahlen pro Token statt 768 wie bei GPT-2, und die Startwerte sind breiter gestreut als in echten Modellen, damit man sie sieht. Fester Zufallsstart, deshalb läuft es bei jedem gleich. Gezeichnet sind 13 der 48 Wörter; „der“, „ist“ und die übrigen lernen mit, bleiben aber unsichtbar. Die Farben vergibt nur die Demo, das Training kennt keine Gruppen. Echte Sprachmodelle sagen nur das nächste Token vorher; zwei Wörter helfen dem Mini-Training, mit wenigen Sätzen auszukommen. Ausgedacht sind die Sätze, nicht die Rechnung: Was ein großes Modell gelernt hat, lässt sich hier nicht ablesen.
Auch die Modelle hinter heutigen Chatbots stellen ihre Tabelle bei jedem Trainingssatz ein Stück nach. Sie lernen nach demselben Prinzip, nur mit Milliarden Sätzen statt einer Handvoll.
Ähnliche Verwendung, ähnlicher Steckbrief
Nachprüfen lässt sich das an GPT-2, dessen Tabelle frei verfügbar ist: Man kann nachrechnen, wie ähnlich die Richtungen zweier Steckbriefe sind. Gleiche Richtung ergibt 1, rechtwinklig 0. In der Skizze zeigen Apfel und Pfirsich fast in dieselbe Richtung, Apfel und Laptop deutlich weniger.
Live-Demo · zum Ausprobieren
Nachbarn im echten GPT-2
Echte Ausgabe, vorab berechnetWähl ein Wort und sieh, welche Steckbriefe in der Tabelle von GPT-2 am nächsten an seinem liegen, und welche Tokens im Vokabular direkt neben seiner Nummer stehen.
„peach“, der Pfirsich, steht schon bei „Vergleichen mit“. In der Skizze kamen Apfel und Laptop auf rund 0,2, rechtwinklige Pfeile auf 0. Vermute, was „laptop“ zu „apple“ bei GPT-2 erreicht: etwa 0, etwa 0,2 oder mehr? Dann stell „laptop“ ein und achte auf den Strich für zwei zufällige Tokens.
Lade die Werte von GPT-2 …
Nummer gegen Steckbrief:
Abstand der Nummern
Ähnlichkeit der Richtungen (1 = gleich, 0 = rechtwinklig)
Die nächsten Nachbarn und die Nummern daneben
Die 8 nächsten Steckbriefe
Direkt daneben im Vokabular
Auflösung
„laptop“ erreicht 0,36, mehr als in der Skizze, aber deutlich weniger als „peach“ mit 0,53, obwohl die Nummer von „laptop“ viel näher an der von „apple“ liegt. Selbst zwei zufällige Tokens kommen im Mittel auf 0,27, weil alle Steckbriefe von GPT-2 ein Stück in eine gemeinsame Richtung zeigen. Entscheidend ist deshalb, wie weit ein Wert über dem Zufall liegt. Die Nummer vergibt der Tokenizer ohne Blick auf die Bedeutung, und die Tokens direkt neben „apple“ im Vokabular haben mit Obst nichts zu tun. Die Zahlen der Zeilen hat das Training eingestellt: Nach „apple“ und „peach“ folgt in Texten oft Ähnliches, also wurden ihre Zeilen ähnlich nachgestellt. Das gilt für jedes Sprachmodell, das seine Steckbriefe im Training lernt.
Echte Werte aus der Tabelle der Steckbriefe der kleinsten GPT-2-Fassung (openai-community/gpt2, Revision 607a30d), vorab nachgerechnet. Gemessen wird, wie ähnlich die Richtungen der Steckbriefe sind; 1 hieße gleich ausgerichtet; als Nachbarn zählen nur ganze Wörter mit Leerzeichen davor, keine Wortstücke, Ziffern oder Satzzeichen. Der senkrechte Strich zeigt, was 20.000 zufällige Token-Paare im Mittel erreichen (0,27). GPT-2 hat ein englisches Vokabular, deshalb stehen auch hier englische Tokens; die deutschen Wörter in Klammern dienen nur zur Orientierung. Gezeigt ist die Nähe am Eingang, bevor das Modell den Satz einbezieht.
Das Rätsel vom Anfang löst sich so auf: „apple“ und „peach“ erreichen bei GPT-2 0,53, „apple“ und „laptop“ nur 0,36. Zwei zufällig gezogene Tokens kommen bei GPT-2 im Mittel auf 0,27, obwohl sie nichts miteinander zu tun haben. Der Laptop liegt also etwas über dem Zufall, der Pfirsich weit darüber, obwohl seine Nummer viel weiter weg ist. Unter den ganzen Wörtern sind „apples“ und „Apple“ die nächsten Nachbarn von „apple“. Danach folgen „cider“ (Apfelwein), „peach“, „lemon“ (Zitrone) und „fruit“ (Obst). Niemand hat dem Modell gesagt, dass das zusammengehört. Diese Wörter standen in ähnlichen Sätzen.
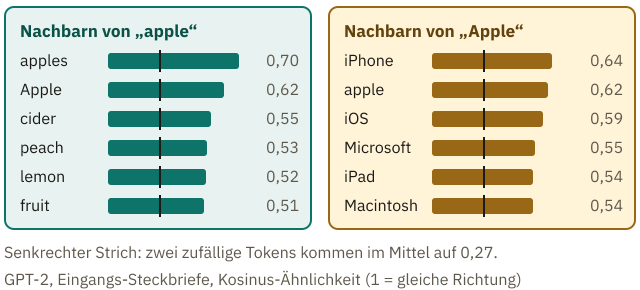
Das großgeschriebene „Apple“ ist für GPT-2 ein eigenes Token mit eigenem Steckbrief. Seine Nachbarn sind „iPhone“, „apple“, „iOS“, „Microsoft“, „iPad“ und „Macintosh“. Microsoft ist weder ein Apfel noch ein Handy. Der Name kommt nur in ähnlichen Texten vor. Ähnliche Steckbriefe stehen deshalb für ähnliche Verwendung im Text. Eine Definition steht in keinem Steckbrief.
Eine Ebene tiefer: Wie misst man, ob zwei Steckbriefe ähnlich sind?
Meist mit der Kosinus-Ähnlichkeit: 1 heißt gleiche Richtung, 0 rechtwinklig, −1 entgegengesetzt. Man nimmt die Zahlen an gleicher Stelle miteinander mal, addiert alle Produkte und teilt durch die Längen der beiden Pfeile (Wurzel aus der Summe der Quadrate). Als Formel: cos(v, w) = (v · w) / (|v| · |w|). Mit der Skizze: Apfel und Pfirsich ergeben 0,9 · 0,8 + 0,1 · 0,2 = 0,74, geteilt durch √0,82 · √0,68 ≈ 0,75, also cos ≈ 0,99.
Bei GPT-2 erreichen „apple“ und „peach“ 0,533, „apple“ und „laptop“ 0,357; 20.000 zufällige Paare im Mittel 0,27, und 95 von 100 lagen unter 0,35. Warum liegt der Zufall nicht bei 0? Alle Steckbriefe zeigen ein Stück in eine gemeinsame Grundrichtung: Beim Nachrechnen ergibt sich für jede Zeile ein positiver Kosinus zum Durchschnitt aller Zeilen. Zieht man diesen Durchschnitt ab, liegen Zufallspaare im Mittel bei 0. Entscheidend ist deshalb der Abstand zum Zufallswert.
Embedding und Embedding-Matrix
Bei GPT-2 hat „apple“ eine ganze Zeile voller Zahlen. Die ersten drei lauten 0,119, −0,175 und 0,129. Was bedeutet die zweite davon? Das kann niemand sagen, und bei den anderen Zahlen der Zeile ist es genauso. An dieser Stelle hinkt das Bild vom Steckbrief: Ein Steckbrief auf Papier hat Felder wie Größe oder Augenfarbe, die jemand ausgefüllt hat. In GPT-2 hat kein Feld einen Namen, und auch Fachbücher halten fest, dass die einzelnen Zahlen keine klare Bedeutung haben. Was ein Steckbrief ausdrückt, steckt in allen Zahlen zusammen.
Eine Ebene tiefer: Was steckt in den übrigen Zahlen?
Die übrigen Zahlen der Zeile sind genauso namenlos. Eine einzelne Stelle steht in der Regel nicht für ein benanntes Merkmal wie „Obst“, und ihr Vorzeichen verrät für sich genommen nichts Greifbares. Wichtig ist das Muster aller Zahlen zusammen. Ein Vergleich mit einem Ausweis hinkt deshalb: Dort steht in jedem Feld etwas Eindeutiges, hier trägt jede Zahl nur einen Teil eines Musters bei, ähnlich wie ein einzelner Strich in einem Gesicht wenig sagt. Zwei Steckbriefe gelten als ähnlich, weil ihre Zahlen insgesamt in dieselbe Richtung zeigen, nicht weil eine bestimmte Stelle übereinstimmt. Deshalb vergleicht man nie nur eine einzelne Zahl. Wer wissen will, ob zwei Tokens verwandt sind, rechnet mit allen Zahlen zusammen.
In der Fachsprache heißt der Steckbrief eines Tokens Embedding, auf Deutsch manchmal Einbettung. Weil er eine geordnete Liste von Zahlen ist, ist er ein Vektor. Die ganze Tabelle mit einer Zeile pro Token des Vokabulars heißt Embedding-Matrix.
Bei GPT-2 hat die Embedding-Matrix eine Zeile für jeden der gut 50.000 Einträge im Vokabular. Mit 768 Zahlen pro Zeile sind das knapp 39 Millionen Zahlen, rund ein Drittel der gut hundert Millionen Parameter dieser kleinsten GPT-2-Version.
Eine Zeile pro Token, nicht pro Wort
Hat „Apfel“ eine eigene Zeile? Das hängt davon ab, wie das Vokabular geschnitten ist. Bei GPT-2 ist „apple“ ein ganzes Token, denn sein Vokabular stammt aus englischen Texten. Deutsche Wörter zerfallen dort oft in Stücke. „Katze“ wird mit Leerzeichen davor tatsächlich zu „␣Kat“ und „ze“; das Zeichen ␣ steht für das Leerzeichen, das zum Stück gehört. „Apfel“ wird zu „␣Ap“, „f“ und „el“.
Für „Apfel“ hat die Embedding-Matrix von GPT-2 also keine eigene Zeile, nur Zeilen für die drei Stücke. Die Zeile „␣Ap“ wird auch für Wörter wie „Apotheke“ benutzt, die mit demselben Stück beginnen. Dass die drei Stücke zusammen das Obst meinen, ergibt sich erst in den Rechenstufen danach.
Warum nimmt man dann nicht einfach ein größeres Vokabular? Im Baustein über Token-IDs hatte ein ausgedachtes Mini-Vokabular fünf Einträge, „Die“, „␣Kat“, „ze“, „␣sitzt“ und „.“. „Die Katze sitzt.“ wird damit zu fünf Tokens, mit „␣Katze“ als sechstem Eintrag zu vier. Dafür bekommt die Embedding-Matrix eine sechste Zeile.
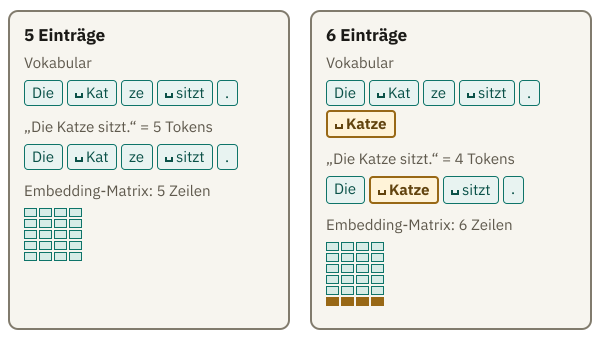
Die neue Zeile kostet immer Platz in der Tabelle. Gespart wird nur, wenn „Katze“ im Text vorkommt: ein Token weniger, also eine Position weniger im Kontextfenster (die Höchstzahl an Tokens, die das Modell auf einmal verarbeitet) und eine Runde weniger beim Antworten. In einem Satz über Hunde bringt sie nichts.
Wie groß soll das Vokabular sein?
Drei Tokenizer von OpenAI haben unterschiedlich große Vokabulare: Der von GPT-2 hat gut 50.000 Einträge, der von GPT-4, einem Modell hinter ChatGPT, rund 100.000 und der seines Nachfolgers GPT-4o rund 200.000. Das größte Vokabular hat rund viermal so viele Einträge wie das kleinste. Wird ein Satz damit auch viermal kürzer?
Live-Demo · zum Ausprobieren
Wie groß soll das Vokabular sein?
Echter Tokenizer, kein ModellDrei echte Tokenizer von OpenAI mit rund 50.000 bis 200.000 Einträgen zerlegen deinen Satz. Bei jedem steht, wie groß eine Embedding-Matrix mit einer Zeile pro Eintrag wäre.
Das größte Vokabular hat rund viermal so viele Einträge wie das von GPT-2. Braucht der Katzensatz damit nur ein Viertel der Tokens? Vermute erst, dann zerleg ihn, auch den englischen Satz.
Vergleiche:
Tokenizer werden geladen …
GPT-2
50.257 Einträge50.257 × 768
GPT-4
100.277 Einträge100.277 × 768
GPT-4o · gpt-oss
200.019 Einträge200.019 × 768
Auflösung
Der deutsche Katzensatz braucht 14, 12 und 9 Tokens, nicht ein Viertel. Der englische Satz braucht bei allen dreien 9. Ein neuer Eintrag spart nur dort, wo sein Textstück vorkommt: GPT-2 kannte „ Katze“ nicht und musste es zerlegen, das größte Vokabular hat es als Ganzes; für die Wörter des englischen Satzes bringen die größeren Vokabulare keine neuen Einträge mit. Die Tabelle wächst dagegen mit jedem Eintrag, ob er im Text vorkommt oder nicht. Darum ist die Größe des Vokabulars bei jedem Sprachmodell eine Abwägung.
Live im Browser: echte Tokenizer aus der Bibliothek gpt-tokenizer, GPT-2 (r50k_base), GPT-4 (cl100k_base) und GPT-4o (o200k_base; gpt-oss nutzt dieselben Textstücke). Einträge samt Spezial-Tokens gezählt. Ein Modell rechnet hier nicht. Die Tabellengröße ist eine Beispielrechnung mit 768 Zahlen pro Zeile wie bei GPT-2; die echten Modelle hinter den beiden größeren Tokenizern haben längere Zeilen, bei GPT-4 und GPT-4o nicht veröffentlicht, bei gpt-oss-20b 2.880 Zahlen.
Der Satz „Die Katze sitzt auf dem Fensterbrett.“ wird bei GPT-2 zu 14 Tokens, bei GPT-4 zu 12 und bei GPT-4o zu 9. Das größte Vokabular hat „␣Katze“ als ganzes Stück, GPT-2 muss es zerlegen. Ein englischer Satz mit demselben Inhalt braucht bei allen dreien 9 Tokens: Für seine Wörter bringen die größeren Vokabulare keine neuen Einträge mit. Ein Eintrag spart nur dort, wo sein Textstück vorkommt.
Die Kosten wachsen dagegen mit jedem Eintrag. Angenommen, GPT-2 hätte mit seinen 768 Zahlen pro Zeile das Vokabular von GPT-4o bekommen: Die Embedding-Matrix wäre dann rund viermal so groß und hätte mehr Zahlen als der ganze Rest des Modells, die Rechenstufen danach. Ein zweiter Preis folgt aus dem Training. Eine Zeile wird im Training vor allem dann nachgestellt, wenn ihr Token im Text vorkommt. Je größer das Vokabular, desto mehr Einträge sind so selten, dass ihre Zeile kaum Übung bekommt. Forscher fanden in verbreiteten Modellen solche untertrainierten Einträge, die seltsames Verhalten auslösen können.
Die beste Größe hängt vom Trainingsaufwand ab, so eine Studie von 2024: Größere Modelle vertragen größere Vokabulare. Ein großes Modell, das mit sehr viel Text trainiert wurde, sieht auch seltene Einträge oft genug; für ein kleines kann schon ein mittleres Vokabular zu groß sein.
Bank bleibt Bank, vorerst
„Ich sitze auf der Bank im Park.“ „Ich zahle Geld bei der Bank ein.“ Am Eingang des Modells ist es dasselbe Token, also dieselbe Nummer und dieselbe Zeile in der Embedding-Matrix. Die Zeile legt nicht fest, welche Bedeutung gerade gemeint ist.
Trotzdem versteht ein Chatbot „Bank“ meist richtig. Der Steckbrief aus der Tabelle ist also nur der Ausgangspunkt.
Ob „Bank“ vorn oder hinten im Satz steht, die Zeile bleibt dieselbe. Wie die Rechenstufen danach den Satz einmischen und woher sie die Reihenfolge kennen, zeigt der nächste Baustein.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.