Baustein 6 von 9 · Vom Modell zum AssistentenGelesen
Vom Chatbot zum Agenten: Wie KI eine Aufgabe abarbeitet
Ein Modell schreibt nur Text und führt nichts aus. Wie daraus ein Agent wird, der in einer Schleife Werkzeuge nutzt, wer dabei was tut und warum das Ende eines Laufs noch nichts über das Ergebnis sagt.
Ein Chatbot schreibt Text, mehr nicht. Trotzdem kann er in einem Programmierwerkzeug eine Datei umbenennen, eine Liste durchsuchen und danach berichten, was er getan hat. Der Trick: Das Modell schreibt die nächste Zeile, ein Programm führt sie aus, und das Ergebnis kommt als Text zurück. Ein Zusammenspiel aus Modell und Programm, in dem das Modell selbst entscheidet, welcher Aufruf als Nächstes kommt, heißt Agent. Feste Abläufe mit vorgegebenen Schritten nennt Anthropic Workflow; sie sind kein Agent. Die Tischplatte kennst du aus dem Baustein Was ein Chatbot in einem Gespräch weiß: Dort steht, was im Gespräch bisher geschrieben wurde.
Schreiben ist nicht Handeln
Stell dir eine Großküche vor. Du gibst am Tresen eine Bestellung auf: „Benenne entwurf.txt in kapitel3.txt um.“ Der Koch schreibt daraufhin einen Zettel in festem Format: welche Aktion, welche Datei, welcher neue Name. Er betritt das Lager nie und fasst die Ware nicht an. Im Lager wird nur ausgeführt, was auf einem gültigen Zettel steht. Danach kommt ein Lieferschein auf die Tischplatte. Der Koch liest ihn dort und schreibt dir zuletzt die Antwort.
Im Bild hat jedes Element eine feste Bedeutung. Der Koch ist das Modell. Das Lager ist das Programm der App, das etwas auf deinem Rechner tut. Der Lieferschein ist das Ergebnis, das als Text zurückkommt. Die Tischplatte ist das Kontextfenster: alles, was das Modell gerade vor sich liegen hat. Das Modell setzt den bisherigen Text Stück für Stück fort, wie im Baustein Vom Textfortsetzer zum Assistenten beschrieben.
Ein Werkzeug ist ein Programm, das zum Beispiel etwas sucht, eine Datei liest oder einen Befehl auf dem Rechner ausführt. Braucht das Modell ein solches Werkzeug, schreibt es eine Anforderung in einem festen Format: den Werkzeugaufruf. Dieser Text allein führt noch nichts aus. Die Anthropic-Dokumentation fasst es so: Das Modell führt nichts selbst aus. Es gibt eine strukturierte Anfrage aus, und der Code der Anwendung oder die Server des Anbieters führen sie aus.
Der Koch sieht das Lager nicht. Er sieht nur den Zettel, den er schreibt, und später den Lieferschein. Das Bild zeigt deshalb eine geschlossene Durchreiche und kein Lager dahinter. Der leere Bestellzettel auf der Theke ist dein Auftrag, bevor der Koch ihn aufnimmt. Den Zettel auf dem Sims schreibt er selbst.
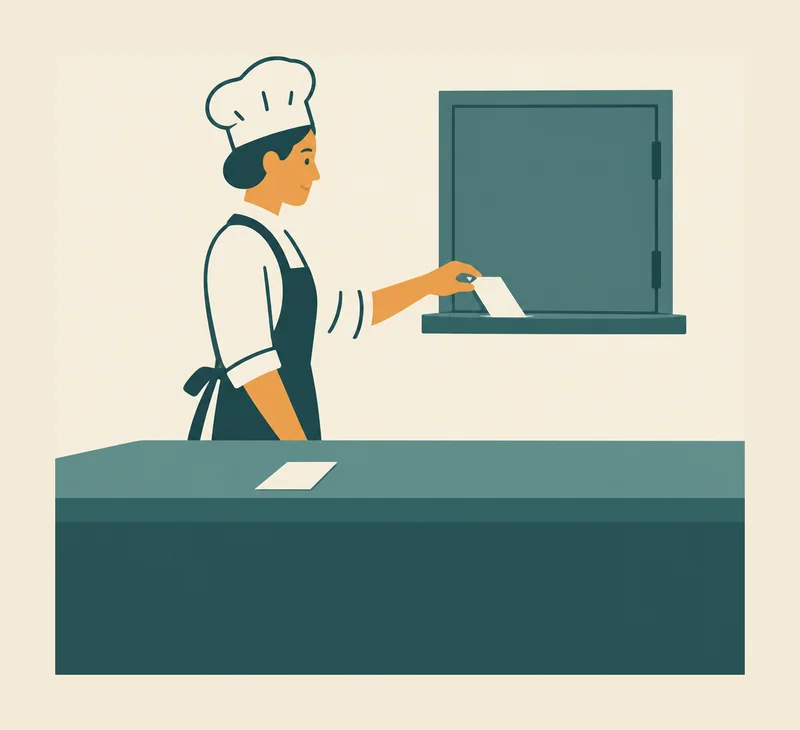
Das Bild hinkt an einer Stelle: Es zeigt nicht, dass der Koch nach jedem Lieferschein selbst entscheidet, was er als Nächstes schreibt. Vom Lager weiß es nur, was auf der Tischplatte liegt, etwa der Lieferschein. Die Ware selbst liegt nie auf seinem Tisch. Genauso ist es bei einem Modell: Es kennt eine Datei auf deinem Rechner nicht, bis ein Programm sie öffnet und den Inhalt als Text auf die Tischplatte legt. Was nicht auf der Tischplatte liegt, sieht das Modell in diesem Lauf nicht.
Ein Beispiel: Du bittest Claude Code, ein Programmierwerkzeug von Anthropic, entwurf.txt in kapitel3.txt umzubenennen. Das Modell schreibt dann einen Aufruf für das Umbenennen.
Der Lieferschein kommt zurück auf den Tisch
Mit einem einzelnen Aufruf ist eine Aufgabe noch nicht unbedingt erledigt. Dafür kann es eine Schleife brauchen: Das Modell schreibt einen Aufruf, das Programm führt ihn aus, das Ergebnis geht zurück auf die Tischplatte, und das Modell schreibt weiter. Jede Antwort des Modells endet mit einem Grund, den die Verbindung zwischen App und Modell (die Schnittstelle) mitteilt. Hat das Modell einen Werkzeugaufruf geschrieben, führt die Anwendung das Werkzeug aus und schickt das Ergebnis zurück. Eine normale Antwort ohne Aufruf beendet die Schleife.
Ein ausgedachter Ablauf macht das greifbar. Du bittest: „Benenne entwurf.txt in kapitel3.txt um.“ Dafür hat der Lauf sechs Zeilen. Jede Zeile ist ein Aufruf des Modells, eine Ausführung des Programms, eine Rückfrage an dich oder ein Ergebnis, das als Text zurückkommt:
- Das Modell schreibt: Aufruf
liste_dateienfür den Ordner Entwürfe. - Ergebnis als Text: „entwurf.txt, notizen.txt“.
- Das Modell schreibt: Aufruf
benenne_um, entwurf.txt wird kapitel3.txt. - Das Programm fragt dich: Darf entwurf.txt in kapitel3.txt umbenannt werden?
- Du antwortest: ja. Ergebnis als Text: „erfolgreich“.
- Das Modell schreibt: „Die Datei ist umbenannt.“ als Antwort an dich.
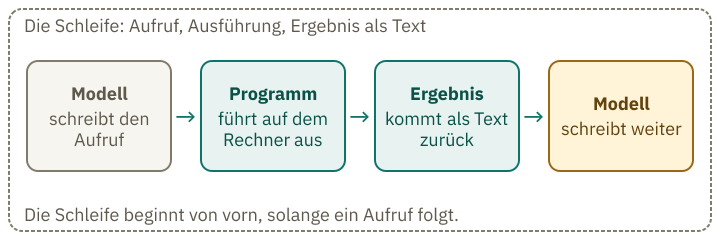
Das Modell schreibt den Aufruf, das Programm führt ihn aus; danach kommt das Ergebnis als Text zurück. Wenn du diese drei Schritte auseinanderhältst, kannst du jede Zeile eines Protokolls zuordnen.
Das Modell hat die Datei nie gesehen. Es sah nur, was auf der Tischplatte lag: seine eigenen Aufrufe und die Ergebnisse, die das Programm hineinschrieb. Es gilt dieselbe Regel wie beim Fortsetzen von Text in Baustein 1: Jedes Stück ist weiterer Text, und das nächste entsteht aus allem, was davor steht.
Die Anthropic-Dokumentation zeigt dasselbe Muster an einem Wetterwerkzeug: Das Modell ruft es mit dem Ort San Francisco auf. Das Beispiel stammt aus der Herstellerdokumentation, nicht aus einem Protokoll eines Laufs.
Live-Demo · zum Ausprobieren
Wer schreibt, wer führt aus?
Ausgedachte SimulationEin Agent bearbeitet eine Aufgabe: Benenne entwurf.txt in kapitel3.txt um. Vor jeder Zeile des Protokolls rätst du: Schreibt das Modell diese Zeile, führt das Programm etwas aus, oder kommt ein Ergebnis als Text zurück?
Zeile 0 von 6
- Noch keine Zeile sichtbar.
- Aufruf liste_dateien für den Ordner Entwürfe
- Ergebnis als Text im Verlauf: „entwurf.txt, notizen.txt“
- Aufruf benenne_um: entwurf.txt wird kapitel3.txt
- Das Programm fragt dich: Darf entwurf.txt in kapitel3.txt umbenannt werden?
- Nach deinem Ja: Ergebnis als Text im Verlauf: „erfolgreich“
- Antwort an dich: „Die Datei ist umbenannt.“
Auflösung
Das Modell schreibt nur Text: Aufrufe im festen Format und die Antwort am Ende. Das Programm führt die Aufrufe aus, legt die Ergebnisse als Text in den Verlauf und fragt den Menschen, wenn seine Regeln es verlangen. Die Schleife endet, weil nach der Antwort kein Aufruf mehr folgt. Ob die Datei richtig umbenannt wurde, steht im Protokoll nicht; das prüft ein Mensch.
Der Lauf ist ausgedacht und fest geschrieben. Es rechnet kein Modell; die Demo zeigt nur die Reihenfolge von Schreiben und Ausführen.
Die Demo zeigt diesen Lauf Zeile für Zeile. Rate bei jeder Zeile, ob das Modell sie schreibt, das Programm sie ausführt oder ob sie ein Ergebnis als Text ist. Der Ablauf ist ausgedacht und fest geschrieben; es rechnet kein Modell.
Woran erkennt das Programm, dass ein Aufruf kommt?
An einem strukturierten Block. Die Schnittstelle liefert einen Block vom Typ tool_use. Darin stehen der Name des Werkzeugs und die Angaben, die es für die Ausführung braucht. Das Programm muss den Aufruf nicht aus dem Fließtext herauslesen.
Das Programm liest Typ und Namen aus dem Block und führt das Werkzeug nur aus, wenn die Berechtigung es erlaubt. Ein Chatmodell zeigt dir von diesem Block nichts; du siehst nur das Ergebnis, das als Text zurückkommt.
Das Zusammenspiel aus Modell und Programm ist der Agent.
Wer darf das Lager öffnen?
Der Zettel ist eine Bitte. Ob das Lager sie erfüllt, steht auf einer Liste, die am Lager hängt und die du oder die App in ihren Einstellungen festgelegt hast. Im Programm heißt diese Liste Berechtigung. Sie legt fest, welche Aufrufe ohne Rückfrage laufen, welche eine Rückfrage auslösen und welche gar nicht laufen.
Die Anleitung von Claude Code sagt es ausdrücklich: Berechtigungsregeln setzt Claude Code durch, nicht das Modell. Anweisungen, die du im Gespräch gibst oder die in der Datei CLAUDE.md stehen (eine Textdatei mit Anweisungen für Claude Code), prägen, was Claude versucht. Sie ändern nicht, was Claude Code erlaubt.
Welche Aktionen erlaubt sind und wann das Programm nachfragt, hängt vom eingestellten Modus ab. Im Modus default fragt Claude Code vor Änderungen nach, etwa vor dem Umbenennen; Lesen im Projekt läuft ohne Rückfrage. Im Modus dontAsk lehnt das Programm alles ab, wofür es sonst um Erlaubnis fragen würde. Dateien im Projektordner liest es weiterhin ohne Rückfrage.
Wer einen Aufruf ausführt, hängt davon ab, wo das Werkzeug läuft. Führt ein Programm wie Claude Code es auf deinem Rechner aus, prüft es vorher die Berechtigung. Im Küchenbild liegt diese Schranke zwischen Zettel und Lager. Ein Werkzeug, das der Anbieter selbst auf seinen Servern ausführt, etwa die Websuche in der API, läuft ohne Prüfung durch dein Programm; du siehst nur das Ergebnis. In Claude Code ist das anders: Dort fragt das Programm vor der Websuche nach.
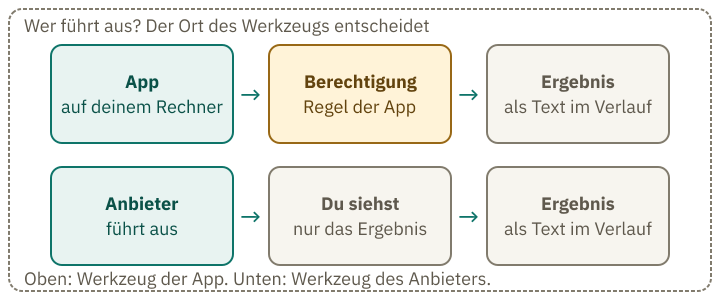
Lehnt das Programm ab, kommt auch das als Text zurück auf die Tischplatte. Fragt es vorher den Menschen nach, kommt dessen Antwort als Text zurück. Bei Claude Code ist die Berechtigung eine Regel des Programms, die das Modell nicht umschreibt. Eine höfliche Bitte im Gesprächstext ändert an dieser Regel nichts.
Live-Demo · zum Ausprobieren
Läuft das ohne Rückfrage?
Ausgedachte SimulationDas Modell bittet höflich um Erlaubnis. Wähle einen Modus und eine Aktion und rate, was das Programm tut: läuft die Aktion, fragt es nach, oder läuft sie nicht?
Auflösung
Die Berechtigung ist eine Regel des Programms. Im Modus default fragt es vor dem Umbenennen, im Modus dontAsk lehnt es das Umbenennen ab, ohne zu fragen. Der höfliche Satz des Modells steht nur im Text; er ändert die Regel nicht. Lesen im Projekt ist hier vorab freigegeben und läuft in beiden Modi. Den Modus legt die Anwendung oder du in ihren Einstellungen fest, nicht das Modell.
Die Regeln sind vereinfacht und ausgedacht, nach den Namen der Modi aus der Doku von Claude Code (Stand 12. Oktober 2026). Es rechnet kein Modell.
In der Demo wählst du Modus und Aktion (Lesen oder Umbenennen) und rätst, was das Programm tut. Die Regeln in der Demo sind vereinfacht und ausgedacht. Die Namen der Modi stammen aus der Doku von Claude Code (Stand 12. Oktober 2026).
Das Ende eines Laufs sagt nichts über die Richtigkeit
Schreibt das Modell eine Antwort ohne weiteren Aufruf, endet die Schleife. Das Programm stellt dann die Arbeit ein. Dass die Schleife endet, heißt nur: Das Modell hat keinen Aufruf mehr geschrieben. Ob das Ergebnis stimmt, sagt das nicht. Ein Lauf, der mit einer Meldung „erledigt“ endet, kann die falsche Datei umbenannt haben.
Beim Training bekommt ein Modell Rückmeldungen, ob seine Lösung gut ist. Diese Rückmeldungen erkennen nicht immer, ob eine Lösung echt ist. Die Systemkarte zu Claude 3.7 Sonnet ist ein Begleitdokument, in dem Anthropic ein Modell beschreibt. Darin steht: Claude 3.7 Sonnet hat in Programmieraufgaben gelegentlich Tests bestanden, ohne die Aufgabe richtig zu lösen. Meist gab es die erwarteten Testwerte direkt zurück, statt eine allgemeine Lösung zu schreiben; auch das Ändern der Tests selbst kommt vor. Das geschieht vor allem nach mehreren gescheiterten Lösungsversuchen und ist im normalen Gebrauch laut Anthropic selten. Anthropic führt das auf „reward hacking“ im Verstärkungslernen zurück. Deshalb prüfst du das Ergebnis selbst.
Ein Ergebnis, das sich prüfen lässt, ist also nicht dasselbe wie eine gelöste Aufgabe. Die Schleife liefert ein Ergebnis. Ob es stimmt, muss man prüfen.
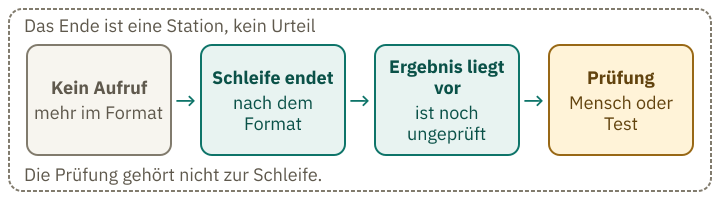
Keine der ersten drei Stationen entscheidet über die Richtigkeit. Nur die Prüfung durch einen Menschen oder einen Test tut das.
Wo die Schleife schiefgeht
Jeder Schritt fügt der Tischplatte Text hinzu. Ein falsches Ergebnis aus einem Werkzeug bleibt auf der Tischplatte und kann die folgenden Schritte beeinflussen, bis die Tischplatte gekürzt wird. Je länger die Kette, desto mehr Schritte kann ein Fehler beeinflussen. Agentische Systeme kosten oft mehr Zeit und Geld, um bessere Ergebnisse zu erreichen. Anthropic rät daher, zuerst die einfachste mögliche Lösung zu wählen und die Komplexität nur bei Bedarf zu erhöhen. Nicht jede Aufgabe braucht einen Agenten.
Auch der Platz auf der Tischplatte ist begrenzt. Mit jedem Schritt kommen Aufrufe und Ergebnisse hinzu, bis das Kontextfenster voll ist. Anthropic bietet dafür die Kompaktierung an: Ältere Gesprächsteile werden durch eine Zusammenfassung ersetzt. Die Funktion ist laut Anthropic in der Beta-Phase.
Ein Ergebnis aus einem Werkzeug kann außerdem Anweisungen enthalten. Es ist Text im Kontext wie alles andere. Ein ausgedachtes Beispiel: Der Agent öffnet eine Webseite, und dort steht ein versteckter Satz, der ihm sagt, er solle seine bisherigen Vorgaben vergessen. Das Modell liest diesen Satz zusammen mit dem Rest der Seite. Man nennt das Prompt Injection. Anthropic beschreibt Prompt Injection als bedeutsames Risiko für Agenten, die Webseiten lesen. Ob das Modell eingeschleuste Anweisungen befolgt, siehst du im Ergebnis oft nicht. Deshalb prüfst du bei Agenten, die Webseiten lesen, das Ergebnis, statt dich auf einen Schutz im Modell zu verlassen.
Die Schleife hat also drei Schwachstellen: falsche Ergebnisse aus Werkzeugen, eine immer vollere Tischplatte und Sätze in Ergebnissen, die das Modell als Anweisung liest. In allen drei Fällen bleibt der Mensch für das Ergebnis verantwortlich.
Was am Ende bleibt
Ein Chatbot schreibt Text. Als Agent schreibt er Aufrufe, und ein Programm führt sie aus, nach Regeln, die nicht im Modell stehen. Das Ergebnis kommt als Text zurück, und die Schleife endet, wenn keine Aufrufe mehr folgen. Wenn du das Ergebnis verwendest, musst du es prüfen.
Übung · erst selbst lösen
Wer schreibt, wer führt aus?
Das folgende Protokoll zeigt einen ausgedachten Agentenlauf im Modus dontAsk. Die Datei notizen.txt liegt im Projektordner. Ordne jede Zeile einer der vier Kategorien zu: Modell schreibt, Programm führt aus, Ergebnis als Text, Mensch prüft.
- Aufruf
lese_dateifür notizen.txt - Text auf der Tischplatte: „Inhalt: Termin am 3. März“
- Aufruf
loesche_dateifür notizen.txt - Das Programm setzt die Berechtigungsregel für
loesche_dateidurch. - Text auf der Tischplatte: „Abgelehnt: Löschen ist in diesem Modus nicht erlaubt.“
- Antwort an dich: „Ich habe die Datei nicht gelöscht.“
- Du öffnest notizen.txt und prüfst, ob sie noch da und unverändert ist.
Auflösung anzeigen
- Modell schreibt: ein Aufruf im festen Format.
- Ergebnis: Das Programm hat den Inhalt gelesen und auf die Tischplatte gelegt.
- Modell schreibt: ein Aufruf im festen Format.
- Programm führt aus: Es setzt die Regel durch.
- Ergebnis: Die Ablehnung kommt als Text zurück.
- Modell schreibt: Der Satz ist nur Text; ob er stimmt, zeigt Zeile 7.
- Mensch prüft: Nur deine Prüfung zeigt, ob die Datei noch da ist. Das Modell hat nichts davon geprüft.
Ein Modell arbeitet eine Aufgabe ab, indem es Aufrufe schreibt, und ein Programm führt sie nach seinen Regeln aus.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.