Baustein 5 von 9 · Vom Modell zum AssistentenGelesen
Was ein Chatbot in einem Gespräch weiß: Vier Quellen, ein Kontextfenster
Woher kommen Antworten im Chat? Aus den im Training eingestellten Reglern, dem Text im Kontextfenster, Werkzeugen oder gespeicherten Notizen. Davon hängt ab, wie verlässlich eine Antwort ist.
Angenommen, du fragst einen Chatbot: „Was habe ich letzte Woche über meinen Garten geschrieben?“ Er antwortet, als hätte er nachgeschlagen, was du damals geschrieben hast. Woher kennt er deine Angaben? Aus dem Training kennt er deinen Garten nicht. Die Antwort stammt also aus Informationen, die ihm im Gespräch vorliegen, oder sie ist geraten. Um das unterscheiden zu können, hilft ein Blick auf die Quellen, aus denen ein Chatbot seine Antworten bildet.
Vier Quellen, ein Kontextfenster
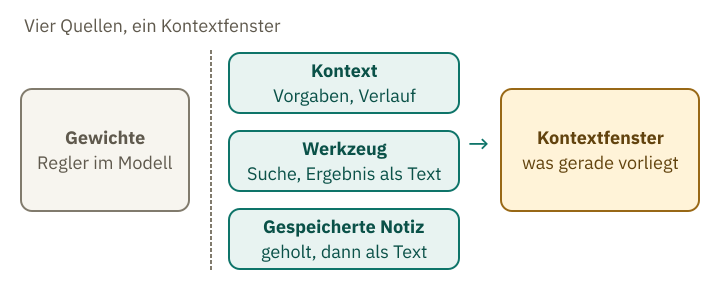
Ein Chatbot kann im Gespräch auf vier Quellen zurückgreifen. Die Gewichte sind die Zahlen, die während des Trainings eingestellt wurden. Im Baustein über das Mischpult heißen sie Regler. Zum Kontext gehört alles, was im Gespräch steht: die Vorgaben der App, der bisherige Verlauf und ein angehängtes Dokument. Über Werkzeuge kann der Chatbot etwa im Netz oder in früheren Chats suchen. Hinzu kommen gespeicherte Notizen: Angaben, die außerhalb des Modells liegen, bis sie abgerufen werden.
Die letzten drei Quellen haben etwas gemeinsam: Sobald ihr Inhalt abgerufen wird, gelangt er als Text ins Kontextfenster. Das Kontextfenster ist die feste Zahl an Plätzen, die ein Modell auf einmal verarbeitet. Im Baustein über Tokens hast du dieselbe Grenze als Prellbock am Gleisende kennengelernt. Hier kannst du dir diese Grenze als die Größe einer Tischplatte vorstellen.
Auf der Platte liegen Zettel: die Vorgaben, der Verlauf, ein Dokument, ein Suchergebnis, eine Notiz. Die Regler stehen nicht auf dem Tisch. Sie sind am Mischpult eingestellt und bleiben, wie sie sind.
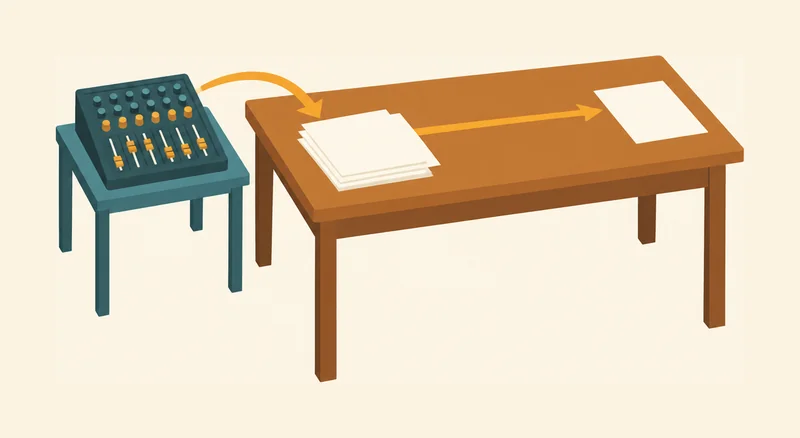
Der Unterschied ist wichtig. Die Gewichte stecken im Modell und wirken auf jede Antwort. Was im Fenster liegt, wirkt auf die aktuelle Antwort. Ob ältere Nachrichten dort bleiben, entscheidet die App: Ist das Fenster voll, kann sie die ältesten herausnehmen. Das Modell verarbeitet alles auf dem Tisch als Eingabe: Text als Text, Bilder als Bilder. Das gilt für einen Satz aus der Systemanweisung ebenso wie für einen Satz aus einer Websuche. Hat die App eine Systemanweisung hinterlegt, schickt sie diese bei jeder Nachricht erneut an das Modell. Die Gewichte bleiben bei jeder Frage dieselben. Am Ende entsteht aus den Zetteln und den Reglern ein Ausgabe-Zettel: die Antwort. Bei der Verarbeitung des Textes kommen die eingestellten Regler zum Einsatz. Ihre Einstellungen ändern sich dabei nicht.
Das Training endet an einem Stichtag
Die Gewichte sind das Ergebnis des Trainings: Dabei werden die Regler eingestellt. Danach bleiben ihre Einstellungen unverändert, auch während eines Gesprächs. Diesen Zusammenhang erklärt der Baustein über Input und Output. Was im Training nicht vorkam, kann das Modell deshalb nicht aus seinen Reglern lesen.
Bis zu welchem Tag das Training reichte, heißt der Wissensstichtag. Für die aktuellen Claude-Modelle nennt Anthropic Juni 2026 zweimal: als Zeitraum, in dem das Wissen am verlässlichsten ist, und als Stand der breiteren Trainingsdaten. Die Angabe steht in der Modellübersicht von Anthropic, abgerufen am 12. Oktober 2026.
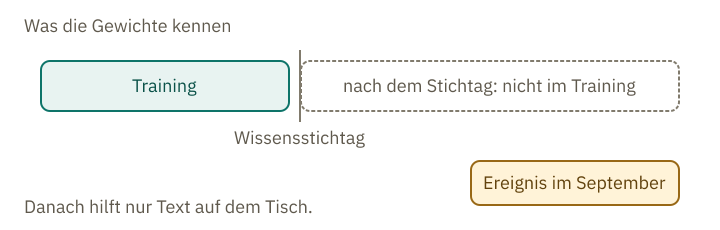
Wissen, das sich nicht ändert, bleibt auch nach dem Stichtag brauchbar. Den Satz „Die Hauptstadt von Frankreich ist …“ ergänzt ein Modell aus den Gewichten, weil diese Angabe in vielen Texten steht und deshalb im Training vorkam. Ein Ereignis aus dem September 2026 fand dagegen erst nach einem Wissensstichtag im Juni statt. Der Chatbot kann davon also nur durch Text im Gespräch erfahren oder eine Antwort raten.
Eine flüssige Antwort verrät dabei nicht, woher sie stammt. Der Ton ist derselbe, ob die Angabe aus den Reglern, aus einer Suche oder aus dem Raten kommt.
Was auf dem Tisch liegt: Vorgaben, Verlauf, Dokumente
Die einfachste Quelle ist der Kontext, den du siehst oder den die App hinzufügt. Dazu gehört die Systemanweisung: die Vorgaben, die vor den Nachrichten des Gesprächs stehen. Du kennst sie aus dem Baustein Vom Textfortsetzer zum Assistenten. Dazu gehört der bisherige Verlauf deines Chats und jedes Dokument, das du hochlädst.
Der Verlauf wirkt wie ein Gedächtnis, ist aber ein Stück Text. Bei jeder neuen Nachricht geht er erneut ins Modell, wie im Baustein über Tokens beschrieben. Anthropic beschreibt jede Runde so: Die Eingabe enthält den gesamten bisherigen Verlauf und die neue Nachricht. Wer über die Programmierschnittstelle schreibt, sieht das in jedem Aufruf.
Anthropic führt genau auf, was zum Kontextfenster gehört: die Systemanweisung, jede Nachricht mit Werkzeugergebnissen, Bildern und Dokumenten, die Werkzeugbeschreibungen und die Antwort selbst. Die Modellübersicht nennt für Claude Opus 5.5 ein Kontextfenster von 1 Million Tokens. Das klingt nach viel, aber alles teilt sich denselben Platz.
Ist die Eingabe allein zu lang, lehnt die Claude-API die Anfrage mit einem Fehler ab. Eine App kann deshalb vorher etwas weglassen oder kürzen.
Die Platte ist also das Kontextfenster, die Zettel darauf sind alles, was im Gespräch steht. Die Regler gehören nicht dazu.
Werkzeuge bringen Zettel aus dem Archiv
Wenn du nach dem heutigen Wetter in Leipzig fragst, fehlt diese Angabe zunächst auf dem Tisch. Um sie zu beschaffen, kann der Chatbot Werkzeuge nutzen. Das sind Funktionen, die ein Programm ausführt. Ihr Ergebnis wird als Text ins Gespräch eingefügt. Die bekanntesten sind die Websuche und die Suche in früheren Chats.
Bei der einfachen Websuche landet jedes Suchergebnis im Kontextfenster, auch wenn viel davon unwichtig ist. Mit dem sogenannten Dynamic Filtering gelangt nur relevanter Inhalt auf den Tisch. Relevant heißt aber nicht richtig.
Ein einmal abgerufener Zettel bleibt außerdem auf dem Tisch liegen. Anthropic schreibt, dass Suchergebnisse, die während eines Gesprächs abgerufen werden, auch in späteren Runden als Eingabe zählen. Sie kosten also weiter Platz.
Laut der Hilfe zu Claude nutzt die Suche in früheren Chats ein Verfahren namens Retrieval-Augmented Generation, kurz RAG. Sie findet passende Abschnitte und legt sie auf den Tisch. Im Chat erscheint sie als Werkzeugaufruf. Inkognito-Chats durchsucht sie nicht.
Die Suche arbeitet wie eine Hilfskraft im Archiv: Sie bringt die Fundstücke zur Anfrage auf den Tisch. Was sie nicht findet, fehlt dort auch dem Modell. Wie verlässlich ein gefundener Zettel ist, hängt davon ab, von welcher Webseite er stammt.
Live-Demo · zum Ausprobieren
Woher kommt die Antwort?
Ausgedachte SimulationVier Fragen, vier Tische. Auf jedem Tisch liegt, was im Gespräch vorliegt. Rate pro Frage: Woher kommt die Antwort? Die Gewichte, der Kontext, ein Werkzeug, eine gespeicherte Notiz oder nur Raten?
Was ist die Hauptstadt von Frankreich?
Auf dem Tisch- Systemanweisung: Antworte kurz und auf Deutsch.
Wie warm ist es heute in Leipzig?
Auf dem Tisch- Suchergebnis (ausgedacht): 12 Grad.
Wie viele Kinder habe ich?
Auf dem Tisch- Gespeicherte Notiz (ausgedacht): „Du hast zwei Kinder.“
Wie ist der aktuelle Stand einer Sache, die sich laufend ändert?
Auf dem Tisch- Systemanweisung: Heute ist der 12. Oktober 2026.
Auflösung
Hauptstadt: Die Antwort steht stabil in den Gewichten, weil dieses Wissen im Training oft vorkam. Die Systemanweisung betrifft nur die Länge und die Sprache. Wetter: Der Wert kommt aus dem Suchergebnis, das als Text auf dem Tisch liegt. Die Gewichte kennen das Wetter von heute nicht. Kinder: Die Angabe steht als gespeicherte Notiz bereit und kommt als Text auf den Tisch. Stand: Der heutige Stand liegt nicht auf dem Tisch, und die Gewichte enden am Wissensstichtag. Die Antwort ist geraten.
Alle Zettel und Fragen sind ausgedacht. Es rechnet kein Modell; die Demo zeigt nur, welche Quelle zur Antwort gehört.
In der Demo siehst du vier Tische mit Zetteln und kannst zuordnen, woher die Antwort kommt. Die Zettel und Fragen sind ausgedacht; ein Modell wird dabei nicht ausgeführt.
Gespeicherte Notizen liegen außerhalb der Regler
Manche Chatbots speichern Angaben, damit sie in späteren Gesprächen wieder auftauchen. Claude legt beim Chatten Erinnerungen als einzelne Themen ab, statt Gespräche erst nach ihrem Ende zusammenzufassen. Die Erinnerung liegt außerhalb der Regler. Wird sie geholt, liegt sie als Text auf dem Tisch, und die Regler ändern sich dadurch nicht.
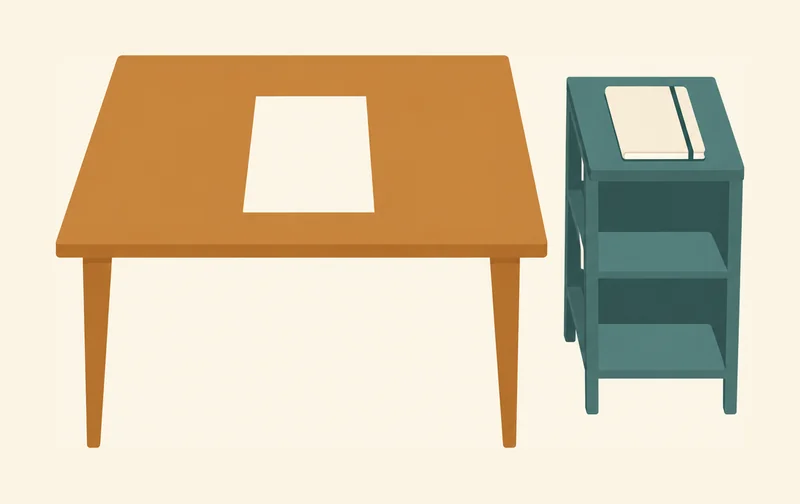
Gespeicherte Notizen von Chat-Apps folgen diesem Muster. Ein Teil des Gedächtnisses liegt außerhalb des Modells, und nur der Ausschnitt, der gerade gebraucht wird, kommt auf den Tisch. Ob und wie eine App Notizen anlegt, entscheidet der Anbieter der App, nicht das Modell. Für dich heißt das: Eine Angabe, die ein Chatbot aus seiner Erinnerung nennt, ist nicht automatisch richtig. Sie ist nur so verlässlich wie die Notiz, und die kann veraltet oder falsch sein. Die Notiz bleibt im Notizbuch, bis die Anwendung sie holt; dann liegt sie als Zettel auf der Platte.
Bei der Programmierschnittstelle ist das genauer.
Eine Ebene tiefer: Wie die API einen Speicher einbindet
Das Memory-Werkzeug der Programmierschnittstelle läuft in der Anwendung, nicht im Modell. Claude fordert Dateioperationen an, etwa das Lesen oder Schreiben einer Datei. Die Anwendung führt sie aus und gibt das Ergebnis zurück. Beim Start eines Auftrags prüft Claude sein Speicherverzeichnis selbst, sodass ein früher abgelegter Eintrag dort wieder erscheint, solange die Anwendung ihn bereithält. Daraus folgt: Löscht die Anwendung eine Datei, ist sie beim nächsten Gespräch nicht mehr auf dem Tisch. Lernen im Sinne des Trainings findet dabei nicht statt: Die Gewichte bleiben gleich, nur der Inhalt des Speichers ändert sich. Für die Praxis heißt das: Was in diesem Speicher liegt, entscheidet die Anwendung, nicht das Modell.
Bei OpenAI wird jede Anfrage zur Textgenerierung für sich verarbeitet; frühere Anfragen gehören nicht automatisch dazu. Soll eine Antwort an die vorige anknüpfen, wird deren Kennung mitgeschickt. Dann kann der Verlauf beim Anbieter liegen. Unabhängig davon speichert OpenAI die Antworten standardmäßig 30 Tage lang. Diese Speicherung lässt sich abschalten.
Bei Anthropic schickt die App den Verlauf in jeder Anfrage mit. Gespeicherter Text beim Anbieter ist damit wieder ein Zettel: Er kommt auf den Tisch, wenn er gebraucht wird.
Die Mitte langer Texte wird oft schwächer genutzt
Wenn alles auf dem Tisch liegt, nutzt das Modell dann jede Stelle gleich gut? Stell dir ein langes Dokument vor, in dessen Mitte eine wichtige Zahl steht.
Im großen Kontextfenster wird nicht jede Stelle gleich gut genutzt. Anthropic schreibt, mehr Kontext sei nicht automatisch besser. Mit wachsender Tokenzahl antwortet das Modell ungenauer und greift weniger zuverlässig auf frühere Angaben zurück. Anthropic nennt diesen Effekt context rot. Der Befund, dass die Mitte langer Eingaben besonders schwach genutzt wird, hat einen eigenen Namen: Lost in the Middle.
Besonders anschaulich ist ein Befund von Liu und Kollegen aus dem Jahr 2024. Sie stellten Sprachmodellen Fragen zu Dokumenten, bei denen die passende Angabe an unterschiedlichen Stellen stand. Die Leistung war oft am höchsten, wenn die Angabe am Anfang oder am Ende stand. Sie sank deutlich, wenn die Angabe in der Mitte langer Eingaben lag, auch bei Modellen, die für lange Kontexte gebaut sind.
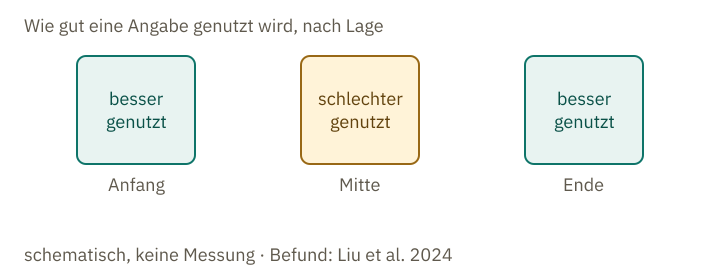
Weitere Studien aus den Jahren 2024 und 2025 zeigen ebenfalls, dass Modelle bei langen Eingaben oft unzuverlässiger arbeiten. Die genauen Zahlen stehen in der Vertiefung darunter. Untersucht wurden eigens eingerichtete Testsituationen, keine Alltagschats.
Eine Ebene tiefer: Zahlen aus den Studien
RULER testete 2024 17 Modelle für lange Eingaben. Bei 32.000 Tokens lieferte nur etwa die Hälfte zufriedenstellende Ergebnisse, obwohl alle ein Kontextfenster von mindestens dieser Größe angaben. NoLiMa testete 2025 13 Modelle. Bei 32.000 Tokens fielen 11 davon unter die Hälfte ihrer Leistung bei kurzen Kontexten. Dabei enthalten die Fragen und die gesuchten Angaben bewusst kaum dieselben Wörter, damit das Modell den Zusammenhang über die Bedeutung erkennen muss. Chroma Research testete im Juli 2025 18 Modelle; die Leistung wird mit wachsender Eingabelänge unzuverlässig, auch bei einfachen Aufgaben.
Die Zahlen gelten für die Modelle, die in den Studien getestet wurden. Sie zeigen, wie ein Modell unter diesen Bedingungen abschneidet, und sagen nichts Sicheres über deinen Chat. Wer die Zahlen nachlesen will, findet die Quellen hier: RULER unter arxiv.org/abs/2404.06654, NoLiMa unter arxiv.org/abs/2502.05167 und die Untersuchung von Chroma Research unter trychroma.com/research/context-rot. Alle drei Arbeiten messen, wie die Leistung mit zunehmender Eingabelänge nachlässt. Sie verwenden dafür unterschiedliche Aufgaben. Deshalb lohnt es sich, bei einer konkreten Frage die Angaben im Original nachzuschlagen.
Für deinen Chat heißt das: Ein hochgeladenes Dokument liegt vollständig auf dem Tisch. Eine Angabe in der Mitte wird trotzdem nicht unbedingt so verlässlich genutzt wie eine am Anfang. Bei Zahlen und Bedingungen lohnt deshalb der Blick ins Original.
Was am Ende bleibt
Die Frage vom Anfang lässt sich jetzt beantworten. Die Angabe über deinen Garten kann nur aus Text stammen, der im Gespräch liegt, etwa aus dem Verlauf, einer Notiz oder einer Suche in früheren Chats. Sonst ist die Antwort geraten. Aus den Reglern kommt sie nicht.
Auf dem Tisch liegt alles als Eingabe, Text ebenso wie Bilder, und nicht jede Stelle wird gleich gut genutzt. Eine wichtige Angabe prüfst du am besten an ihrer Quelle: an der Webseite, der Notiz oder dem Dokument, aus dem sie stammt. Eine Antwort allein ist dafür kein Beleg.
Übung · erst selbst lösen
Woher kommt die Aussage?
Das Gespräch ist ausgedacht. Ordne jede Aussage einer möglichen Quelle zu: Gewichte, Kontext (Vorgaben, Verlauf oder Dokument), Werkzeug oder gespeicherte Notiz.
- „Die Hauptstadt von Frankreich ist Paris.“
- „Gerade eben hast du geschrieben: Mein Balkon zeigt nach Süden.“
- „Heute liegt die Temperatur in Leipzig bei 12 Grad, laut dem Wetterdienst.“
- „Antworte kurz und auf Deutsch.“
- „Auf Seite 3 steht die Frist 30. Juni.“
Auflösung anzeigen
1 stammt aus den Gewichten: Das ist stabiles Wissen, das im Training vorkam. 2 stammt aus dem Verlauf: deine eigene Nachricht liegt als Text auf dem Tisch. 3 stammt aus einem Werkzeug: Die Suche hat die Angabe gefunden und als Text auf den Tisch gelegt. Ob die Angabe des Wetterdienstes stimmt, ist damit noch nicht geprüft. 4 stammt aus dem Kontext: eine Anweisung, die als Text ins Gespräch kommt, etwa eine Systemanweisung oder deine Bitte. 5 stammt aus dem Kontext, aus einem angehängten Dokument.
Die Quelle sagt, woher ein Satz kommt, nicht ob er stimmt. Der Satz über die Frist ist nur so verlässlich wie das Dokument, das auf dem Tisch liegt.
Einfacher erklären lassen
- Einfacher erklärenKernaussage und ein Vergleich aus dem Alltag
- Mit BeispielEin konkretes Beispiel, Schritt für Schritt
- AusführlicherJeder Gedankenschritt einzeln, in einfacher Sprache
Abrufmoment
Was ist hängen geblieben?
Beantworte die Fragen ohne zurückzuscrollen. Es geht nicht um eine Note, sondern darum, das Gelernte einmal aus dem Gedächtnis abzurufen. Sobald du eine Antwort anklickst, siehst du, ob sie stimmt.
Fragen werden vorbereitet …
Fragen aus der Community
Etwas ist unklar geblieben? Stell deine Frage zu diesem Baustein im Community-Board. Dort antworten andere Lernende und das Projekt — und du siehst, was andere schon gefragt haben.